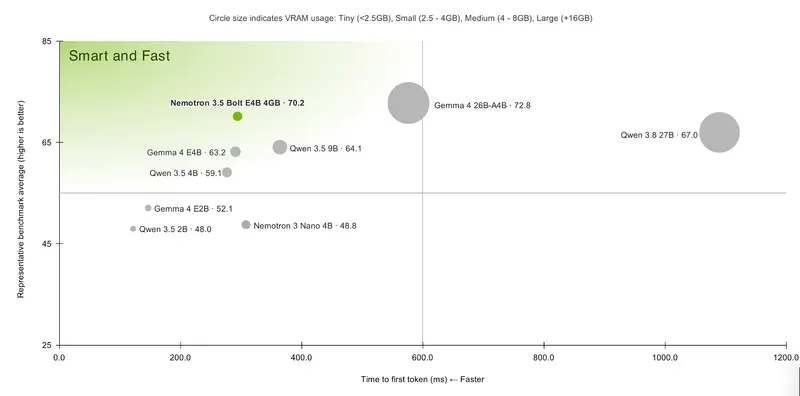
英伟达发布 Nemotron 3.5 Bolt E4B 4GB,一款轻量化开放模型,定位本地对话Agent,适配RTX消费显卡、Jetson嵌入式平台、RTX Spark,主打语音助手、游戏互动NPC、机器人交互场景。该模型基于Gemma 4 E4B底座,全程只用强化学习做后训练,没有监督微调SFT,目标显存占用控制在约4GB,留出显存空间给语音、视觉模型。
- GitHub:https://github.com/NVIDIA-NeMo/Automodel/blob/main/docs/model-coverage/vlm/nvidia/nvidia-nemotron-3-5-bolt-e4b-4gb-bf16.mdx
- 模型:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-BF16
- GGUF:https://huggingface.co/nvidia/NVIDIA-Nemotron-3.5-Bolt-E4B-4GB
基础规格
总参数8B,有效参数4B,上下文窗口64K;Q4_K_M量化版本实测显存占用3.1–4.3GB。
核心面向多轮工具调用对话,内置专属特性:
- 支持异步多轮工具调用
conversational_mode模式,输出简短、适配语音播报- 可配置推理预算,用来控制延迟
- 64K上下文容纳对话历史、工具描述、设备状态
训练方案摒弃SFT:团队发现SFT虽然提升工具调用,但会破坏原生对话风格、容易啰嗦;改用RLVR+RLHF,样本维持2:1(非推理样本:推理样本)配比,搭配长度惩罚抑制冗余输出,数据集与训练配方公开。配套DFlash草稿器支持推测解码,RTX 5070下可达272.6 token/s,比原版Gemma 4 E4B提升约21%。
基准表现(英伟达自测BF16)
一共21项基准,Bolt在其中15项拿到第一,平均得分相比上代Nemotron 3 Nano 4B提升约40%,生成冗余Token最高减少80%;Scale Labs MultiChallenge评测中小模型组别排名第一(56.03%)。
亮点:IHEval 84.8,大幅领先Gemma 4 E4B(67.0)、Qwen3.5-4B(60.6)
短板:Tau2-Bench仅55.1,明显弱于Qwen3.5-4B的75.1;长文本RULER 64K、LongBench v2同样不及Qwen3.5-4B。
硬件部署实测(Q4_K_M,batch=1)
- RTX 5070:3.5GB显存,133.4 token/s
- RTX Spark:3.1GB显存,67.0 token/s
- Jetson AGX Orin:4.2GB显存,24.0 token/s
- Jetson Orin Nano:4.2GB显存,15.5 token/s
注:“4GB”是目标显存包络,Hugging Face上Q4_K_M GGUF文件实际大小6.18GB。
分发渠道:Hugging Face、Ollama、LM Studio、Unsloth、Jetson AI Lab;同时提供NIM服务、游戏内推理SDK。许可证为 OpenMDW-1.1。
© 版权声明
文章版权归作者所有,未经允许请勿转载。