Mistral AI 近日正式发布了 Voxtral 3,这是一个全面的语音模型家族,并配套推出了语音代理 SDK。该系列包含 3 个转录模型、1 个文本到语音(TTS)模型以及一个基于 LiveKit 构建的 SDK,旨在为开发者提供一个集聆听、推理、工具调用和语音回复于一体的统一平台。所有 4 个模型目前均已在 Mistral API 上开放预览。
- API:https://console.mistral.ai/api-keys
Voxtral 3 模型家族矩阵
Voxtral 3 针对不同场景提供了模块化的模型选择,所有转录模型均支持说话人分离和上下文偏置(通过关键术语或自由文本提高召回率),并覆盖 50 种语言(含 24 种欧盟官方语言)。
- Voxtral Small Transcribe 3:旗舰级批处理转录与说话人分离模型,同时支持翻译、语音问答、摘要和函数调用。
- Voxtral Mini Transcribe 3:一个 40 亿参数的轻量级模型,专为资源受限环境设计,提供更快速、更低成本的批处理工作流,支持 32k 上下文。
- Voxtral Mini Transcribe Realtime 3:基于 WebSocket 的流式自动语音识别(ASR)模型,内置轮次结束检测(VAD)功能。
- Voxtral Speech 3 (TTS):文本到语音模型,支持约 90 毫秒的首音频延迟和 34 种情感标签。其 Pro Voice 功能可通过 30 分钟音频自适应说话者风格。
语音代理 SDK 架构
Voxtral 语音代理 SDK 基于 LiveKit 构建,将复杂的语音交互解耦为三个独立但无缝衔接的流式阶段:
- 聆听:Realtime Transcribe 3 负责实时监听并检测用户何时停止说话。
- 推理:通用 LLM(如 Mistral Small 4)处理转录文本,执行逻辑推理并调用外部工具。
- 说话:Voxtral Speech 3 根据当前对话的语境和语气生成语音回复。
这种模块化设计使得每个轮次可在 1 秒内完成,并原生支持打断(barge-in)功能。当用户插话时,代理会立即停止发声。该 SDK 同时支持通过 SIP 处理传统电话呼叫,以及通过 WebRTC 处理浏览器或移动端应用会话。由于各阶段模型相互独立,开发团队可灵活替换其中的 LLM、音色或语言模型。
基准测试与性能表现
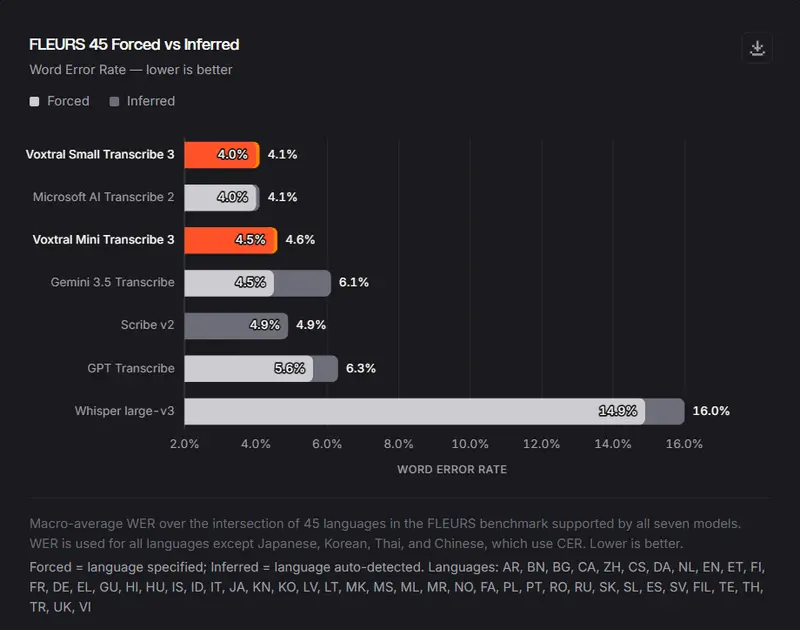
根据 Mistral 提供的自报数据及第三方评测,Voxtral 3 在多项指标上表现强劲,但在极低延迟的实时场景下仍有妥协:
- 批处理与说话人分离:在 Artificial Analysis 排行榜上,Small Transcribe 3 的 AA-WER(平均词错误率)达到 2.1%,位列第三。在说话人分离测试中,其 cpWER 为 18.4%,优于 Pyannote (19.0%) 和 MAI-Transcribe-2 (20.3%)。在 Earnings-22 关键词召回测试中,启用上下文偏置后 F1 分数高达 94.6%。
- 实时转录的权衡:在 FLEURS 35 测试中,实时模型以准确性换取了低延迟。在 240 毫秒的极低延迟下,WER 升至 7.4%,略逊于 Gemini 3.5 Realtime (4.2%) 和 MAI-Transcribe-2 Streaming (5.8%),但仍优于 GPT Live Transcribe (8.4%)。
部署选项与定价策略
Voxtral 3 模型可通过 Mistral 的欧洲、美国和全球端点调用,OpenRouter 也提供了支持欧盟托管(零数据保留)的接入选项。此外,企业也可通过 Mistral 销售团队将其部署于自有基础设施上。
定价方面,Voxtral 3 保持了较高的性价比:
- 批处理转录:Mini 模型 $0.0035/分钟,Small 模型 $0.004/分钟。
- 实时转录:$0.008/分钟。
- TTS 生成:$13 / 100 万字符(Mistral 称此价格低于 OpenAI TTS-1、Deepgram、ElevenLabs Flash 和 Gemini Flash)。
- 语音代理 API:搭配 Mistral Small 4 推理模型为 $0.04/分钟,搭配其他推理模型为 $0.08/分钟。
© 版权声明
文章版权归作者所有,未经允许请勿转载。