Exa Labs 近日发布了 Exa 3.0,这是对其面向 AI 代理的网页搜索 API 的一次重要升级。新版本通过改进检索栈和引入新的计费层级,旨在为开发者提供更高效、更具成本效益的检索方案。
检索质量的三项核心改进
Exa 3.0 的性能提升主要归功于检索架构中的三个变化:
首先是采用了规模更大的嵌入模型。Exa 投入了更多的计算资源和数据来训练该模型,尽管具体的参数数量尚未公开,但这直接提升了语义匹配的精度。
其次是 Dynamic Highlights(动态高亮)功能的正式可用。传统的检索往往返回整页文本,而 Dynamic Highlights 允许模型跨所有搜索结果智能选择关键 token。它会为高质量页面分配更多 token,同时丢弃重复信息。据 Exa 官方数据,这种方式比返回整页文本减少了 95% 的 token 消耗,且不收取额外费用。对于高度依赖上下文 token 的 AI 代理工作流而言,这能显著降低整体推理成本。
最后是索引库的大幅扩展。除了常规网页,新索引覆盖了 12.7 亿条带价格和库存状态的电子商务列表、2.11 亿家本地企业,以及实时的新闻、体育、天气和市场数据。Exa Library 还将这些数据结构化,包含 3.2 亿个人物页面、3300 万个公司页面、5 亿篇研究论文,以及数千万份 SEC 文件、专利和法院意见。
Exa Lite:更具性价比的检索选项
为了满足不同场景的成本需求,Exa 3.0 引入了 Exa Lite 搜索类型。Lite 模式与 Exa Auto 运行在同一个索引上,但在候选生成、高亮处理和排名阶段消耗的计算资源更少。
在定价上,Lite 模式为每 1,000 次请求 4 美元,而 Auto 模式为 7 美元。相比之下,Perplexity、Brave 和 Parallel 的同类高级接口标价多为 5 美元。需要注意的是,Lite 模式不支持所有高级参数(如某些复杂的过滤条件),如果传入不支持的参数,API 会直接返回 400 错误并指明字段。因此,部分复杂管道仍需依赖 Auto 模式。
基准测试表现与局限性
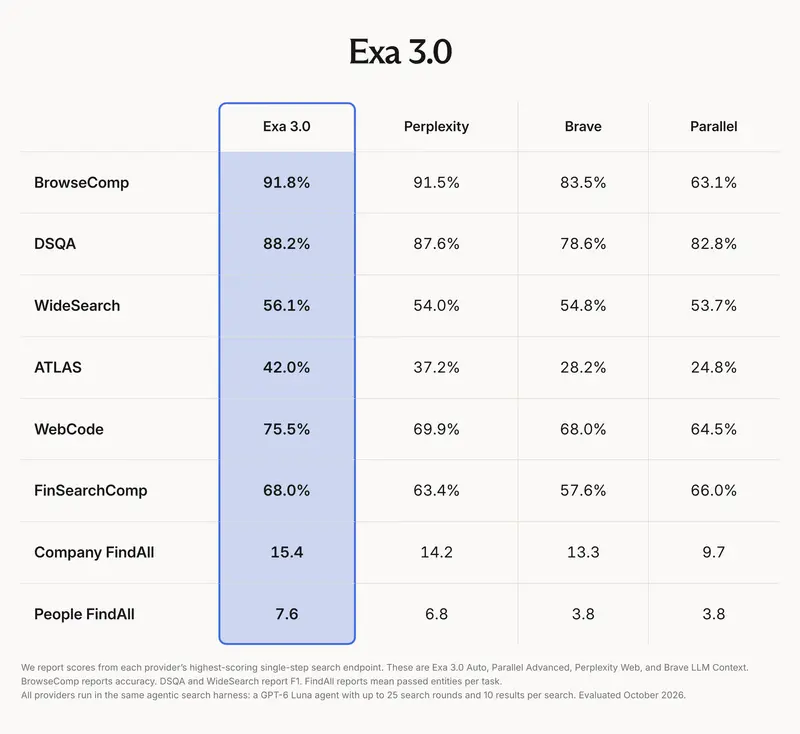
Exa 在 8 个基准测试中对比了 Exa 3.0 Auto、Perplexity Web、Brave LLM Context 和 Parallel Advanced。测试环境统一使用 GPT-6 Luna 作为代理模型,最多进行 25 轮搜索,每次返回 10 个结果。
数据显示,Exa 3.0 Auto 在这 8 个测试中均位列第一。其优势在 WebCode(领先 5.6 分)和 ATLAS(领先 4.8 分)上最为明显。但在 BrowseComp 等测试中,其对 Perplexity 的领先优势仅为 0.3 个百分点,差距较为微弱。
在评估这些数据时,有几个客观限制需要开发者留意:
- 评估由 Exa 自行运行,且 ATLAS 是 Exa 自身发布的基准,测试环境和代理模型的选择可能存在偏向性。
- 部分微弱的领先优势在其他测试框架(harness)中可能无法复现。
- 嵌入模型的具体规模和底层架构细节仍未披露。
对于正在构建 AI 代理的开发者而言,Exa 3.0 提供的 Lite 模式和 Dynamic Highlights 确实为控制 token 成本提供了新思路。但在决定切换搜索提供商之前,建议在实际的业务查询和数据集上进行独立测试,以验证其检索质量是否真正符合特定场景的需求。
© 版权声明
文章版权归作者所有,未经允许请勿转载。