蚂蚁百灵开源 Ling-3.1-flash,原生MoE混合推理大模型,总参数量560B,每token仅激活25B参数,最大支持100万token上下文窗口,面向企业知识问答、办公助手、智能体、代码工程等真实业务场景。
- Hugging Face:https://huggingface.co/inclusionAI/Ling-3.1-flash
- ModelScope:https://modelscope.cn/models/inclusionAI/Ling-3.1-flash
核心规格与量化部署优化
模型原生MoE架构,针对本地私有化部署做量化优化:路由专家采用MXFP4量化,稠密层保留block-FP8。量化后权重体积从534GB压缩至292GB,部署硬件门槛从8张Hopper GPU降低至4张Hopper。
实际资源消耗依然受上下文长度、并发量、服务配置影响。
推理性能指标
- 长资料场景(输入25.47K token,输出224 token,缓存命中率76%,8卡Hopper):首token耗时604ms,相邻token平均间隔3.28ms,适合长文档读取后的快速交互。
- 吞吐压测场景(输入8.5K token,输出800 token,4卡Hopper):达到1.36 QPS,同时满足P50首Token<3秒、P90 token间隔<70ms,方便企业做集群容量规划。
- 评测数据:Artificial Analysis智能指数41,输出速度约210 token/s。
- 技术方案:PCP/DCP长上下文并行推理;算子融合+DSpark投机解码降低推理开销;强化JSON Schema工具调用,更容易对接业务接口。
能力覆盖与基准表现
在Ling-3.0-flash基础上升级架构,重点提升现实世界任务表现:
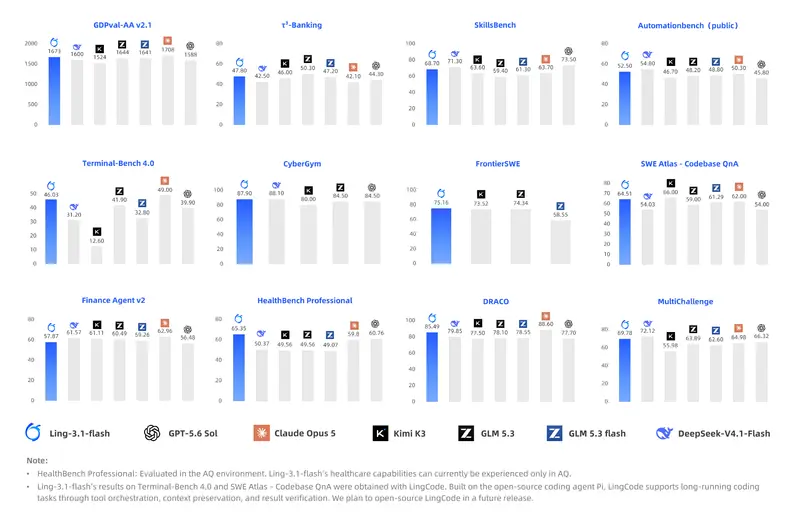
- 智能体与自动化:Terminal-Bench 4.0、Automationbench、MCP-Atlas、SkillsBench;可在Claude Code、Kilo Code等主流Agent框架稳定运行。
- 代码:SWE-bench Pro、FrontierSWE;配套自研LingCode测试框架,适配持续数小时、数百轮工具调用的长周期编码任务,未来计划开源。
- 专业领域:GDPVal-AA V2.1办公任务、HealthBench Professional医疗,金融、材料科学场景同样获得提升。
在线调用价格(限时2.5折)
- Openrouter美元计费:输入 $0.075 / M token,输出 $0.225 / M token,缓存读取 $0.015 / M token。
- 国内Tbox人民币计费:输入0.5元/M token,输出1.5元/M token,缓存读取0.1元/M token。
© 版权声明
文章版权归作者所有,未经允许请勿转载。