a16z引用OpenRouter平台统计数据,揭示AI智能体带来的新行业痛点:智能体消耗的Token总量已经达到人类用户的5倍,未来有望攀升至10倍甚至更高;超过85%智能体产生的Token都来自提示词缓存,也就是反复读取已经看过的历史上下文。
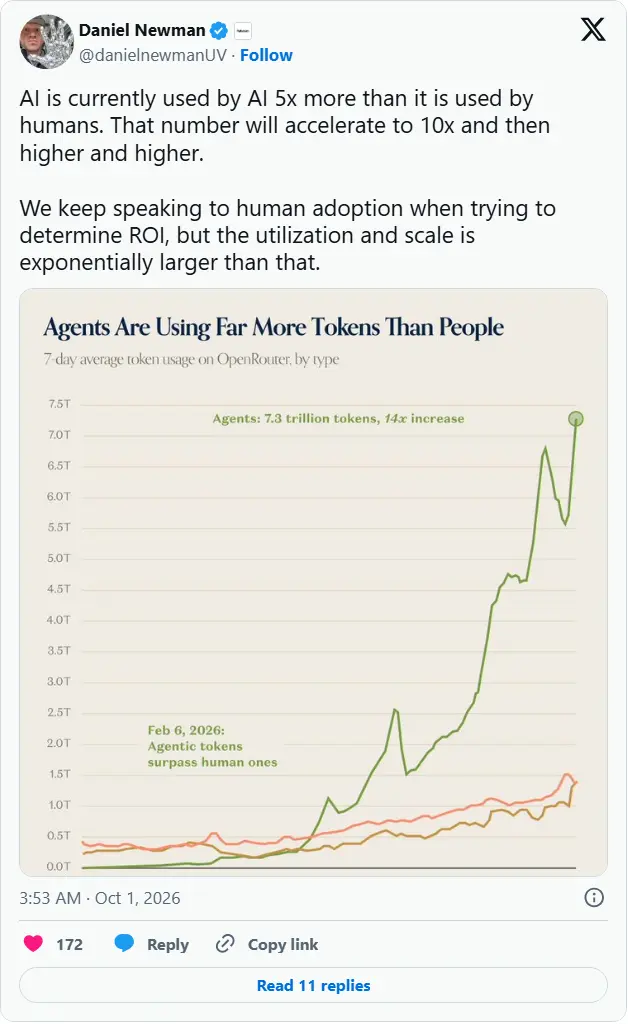
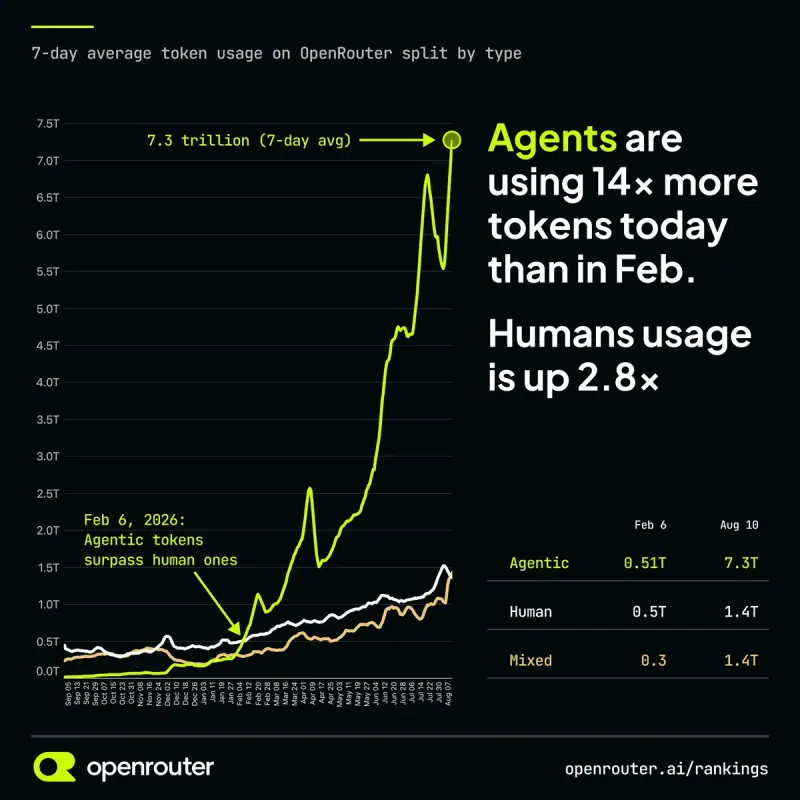
OpenRouter会通过工具调用频率、对话轮次、请求时序等7项信号,将API流量划分为三类:agentic智能体、mixed人机混合、human人类。数据显示,截至8月平台智能体Token总量7.3万亿,人类仅1.4万亿。自今年2月智能体流量反超人类的拐点之后,智能体Token用量暴涨14倍,人类用量仅提升2.8倍,混合场景流量增长4.7倍。
关键洞察:智能体绝大多数Token开销,不是生成全新信息,而是反复加载过往对话、历史文档。在另一组Claude Code智能体实测日志里,输入内容中96%都是重读旧对话。
虽然缓存Token计费价格远低于全新输入,但KV缓存数据必须驻留在HBM高带宽内存里。这就造成一个矛盾:账面Token费用看着可控,但硬件层面的内存占用压力巨大,KV缓存需求正在逼近、甚至超出GPU HBM容量上限。
行业供给侧的压力同样严峻。美光预测,内存、存储紧缺会在2027–2028年进一步加剧,存储厂商产能优先供给AI数据中心HBM。如果智能体Token消耗持续放大到10倍、20倍甚至30倍,不管是云端大模型服务器,还是本地PC端部署AI智能体,都会掀起内存资源争夺。
麦肯锡2026AI调研也佐证趋势:40%大型企业正在扩大AI智能体落地,高于去年的27%。不过该数据仅来自OpenRouter单一平台,只统计Token数量,不等于实际支出;期间4月、7月流量也曾出现回落,不能完全代表全行业全貌。
要点总结
- 流量数据:OpenRouter上智能体Token量7.3万亿,人类1.4万亿,当前5倍差距,预测后续拉到10倍以上。
- 本质问题:85%+智能体Token来自重读历史上下文(KV缓存),不是新信息;缓存便宜,但极度占用HBM内存。
- 硬件压力:KV缓存挤占GPU内存,HBM供给紧张,2027-2028短缺会继续恶化。
- 边界说明:数据来自单一平台,统计对象是token数量而非费用;企业端智能体落地规模正在扩张。
© 版权声明
文章版权归作者所有,未经允许请勿转载。