OpenAI在10月2日发布GPT‑6系列模型官方使用指南,面向开发者讲解整套落地技巧,核心目标是在可控延迟与成本的前提下,最大化发挥GPT-6系列能力,覆盖生产部署、模型选型、提示词优化、长时间智能体任务四大板块。
一、生产环境高效运行方案
部署前需要完成测试、指标监控与数据安全校验,重点利用缓存、上下文压缩控制开销:
- 提示词缓存:复用固定上下文,缓存输入Token最高可省95%费用。建议将固定指令、参考文档前置,保持工具定义统一;配套缓存仪表盘定位缓存失效场景,成本核算时要计入缓存写入费用与长上下文费率。
- 上下文压缩:长对话场景缩减上下文体积,保留关键状态,降低Token消耗。
- 工程策略:精简不必要上下文、独立任务并行执行,避免慢步骤阻塞整体流程;上线前实测任务成功率、延迟、单次完成成本。
二、按业务负载选择模型、推理强度与速度
模型选型
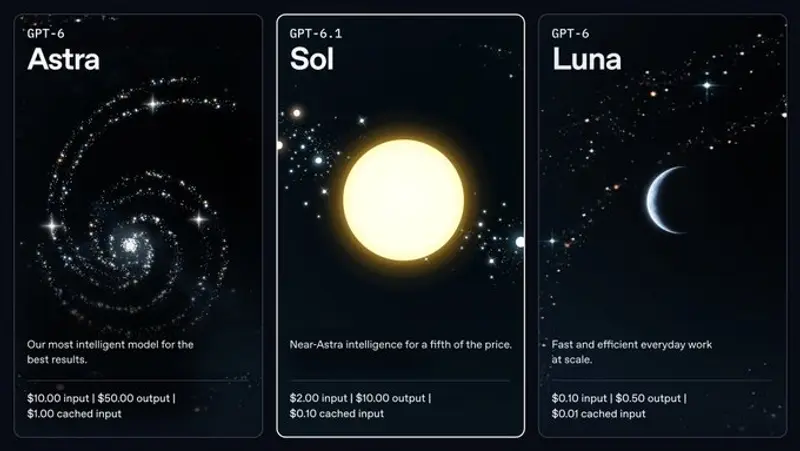
- GPT‑6 Astra:最高推理能力,应对高难度复杂任务
- GPT‑6.1 Sol:复杂编程、研究、计算机使用场景
- GPT‑6 Luna:大规模批量处理、结构化提取、分类、摘要等重复性任务
推理强度(API可在对话中途调整,不会让缓存失效)
- 低:事实提取、小幅修改等常规任务
- 中:方案对比、功能规划,需要基础判断
- 高:深度调试、精细审查、复杂分析
- 极高/Max:仅在收益覆盖额外耗时与成本时使用
速度模式
- 快速模式:聊天、编程等高响应需求场景,响应更快更稳,单Token价格更高
- 超高速模式:只加速Token生成,不改变推理强度,适合代码快速迭代,仅支持GPT‑6 Astra
三、提示词与技能编写思路更新
OpenAI开发者团队提到:GPT-6理解细微语义的能力大幅提升,过去冗长详尽的提示词,现在反而会限制模型发挥。
- 明确交付目标、受众、约束条件与“任务完成”判定标准;
- 精简技能描述,按需加载补充信息,替换僵化步骤指令;
- 借助AGENTS.md划定权限边界:区分模型可自主执行操作、需要人工审批的操作,不要简单设置“凡事必先询问”;
- 定义完整闭环:改动、运行、校验、修复,明确交接输出格式。
四、长时间运行智能体任务管理
GPT‑6系列可支撑持续数小时乃至多天的任务,提供多套机制管控智能体:
API侧
- 中途引导:WebSocket可在任务运行中下发修正指令,不中断正在执行的工具调用、不回滚已完成工作
- 异步工具:应用执行慢速任务(测试等)期间,模型可并行处理其他独立工作
- 多智能体委派:GPT‑6.1 Sol可拆分子任务,分派给子智能体并行处理、汇总结果,目前处于测试阶段
Codex侧
任务进行中可随时澄清疑问、动态调整需求;可告知模型在等待人工决策时,哪些工作可以继续执行、哪些需要暂停。
五、计算机使用能力
Astra / Sol / Luna均支持直接操作网页、桌面软件,无需应用开放API,用于排查bug、改代码、网页验证等场景。
最佳实践优先级:优先API/工具调用;只有需要屏幕读取、点击、表单填写时,启用计算机使用能力;开发集成可基于Playwright(浏览器)、PyAutoGUI(桌面)搭建。
核心要点总结
- 成本核心手段:提示词缓存最高节约95%输入Token成本,搭配上下文压缩,配套监控缓存命中率。
- 分层选型:Astra强推理、Sol编程/Agent、Luna批量结构化任务;推理强度可动态切换,不破坏缓存。
- 提示词理念转变:减少冗余指令,清晰定义权限边界、任务完成标准,而非堆砌大量约束。
- 长任务能力:支持中途动态引导、异步工具、子任务委派,适配跨小时级智能体工作流。
- 计算机使用能力:可直接操作浏览器与桌面应用,作为API之外的补充方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。