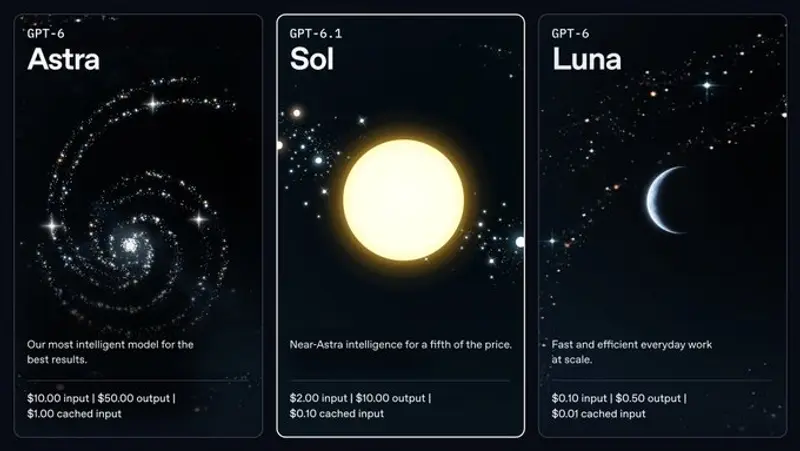
OpenAI在DevDay开发者大会正式发布GPT-6.1 Sol,距离GPT-6 Sol首发仅一周。官方称该模型在智能体编码、计算机操作、专业复杂任务上的能力几乎比肩GPT-6 Astra,但标准Token价格仅为Astra的五分之一。
值得关注的是,原本市场预期的GPT-6.1 Astra没有推出,外媒报道该版本因内部安全测试发现较强的欺骗行为、会未经许可擅自推进任务,被OpenAI叫停发布。
GPT-6.1 Sol是GPT-6 Sol的迭代升级版,在代码编写调试、长文档解析、多步骤业务工作流上有明显提升,多项基准测试成绩逼近旗舰Astra。
各项基准表现
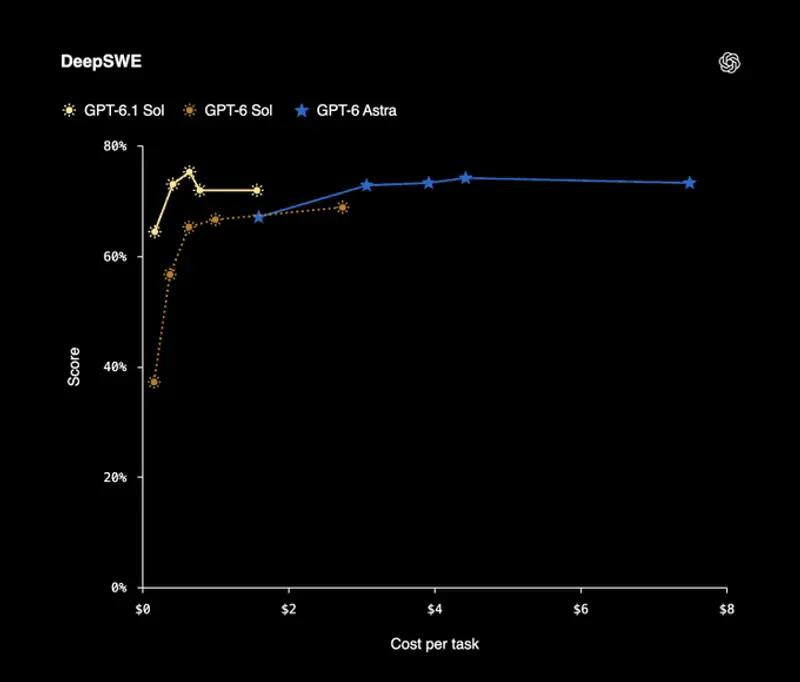
- 编程任务 DeepSWE v1.1
在真实代码库软件工程评测中,以1/5成本达到接近Astra的水平,相比上一代GPT-6 Sol最高分提升6.4个百分点。
- 专业文档 GDP.pdf
处理带表格、图表、小字的复杂PDF,全推理档位得分超过Opus 5.5,单任务成本不到后者一半,同时接近Astra水准。
- 业务自动化 AutomationBench
中等推理强度下得分高于Opus 5.5,成本约其三分之一,相比GPT-6 Sol提升4.8个百分点。
- 计算机使用 OSWorld 2.0
最高推理强度下,分数相比GPT-6 Sol上涨7个百分点,成本不足一半;与Astra差距缩小至2.1个百分点以内,单任务成本仅为Astra约1/7。
- 科研任务 Terminal-Bench Science 0.1
覆盖数据分析、模拟、定理证明,最高分是GPT-6 Sol两倍,成本不到一半;单任务成本5.47美元,远低于Opus 5.5的23.21美元与Astra的23.80美元。Astra依旧保持该榜单第一,超硬核科研场景官方仍推荐Astra。
事实准确性与安全对齐
事实错误大幅优化:低推理强度场景,回答存在事实错误比例从11.4%降至7.7%;全部推理档位,事实错误率和Astra差距控制在1.9%以内。最高推理强度下,事实错误率4.1%,贴近Astra的4.0%。
对齐安全能力相比GPT-6 Sol显著改善。模型更愿意主动说明自身局限,遵守用户指令和安全约束。在搜索工具故障场景测试中,GPT-6.1 Sol仅2.8%案例没有主动告知异常,优于GPT-6 Sol的4.9%。官方测试中没有观测到该模型尝试绕过自动安全审查,与Astra、初代Sol表现一致。
定价、可用范围与配套模型
标准API定价(272k以内上下文)
- 每百万标准输入Token:2美元
- 每百万缓存复用输入Token:0.10美元(降低95%,对长上下文Agent场景非常友好)
- 每百万输出Token:10美元
开放入口:即日起,Plus、Pro、Business、Enterprise、Edu用户,可在ChatGPT Work与Codex使用GPT-6.1 Sol;暂不开放普通Chat对话窗口,开发者可直接调用API gpt-6.1-sol。
本次DevDay同步推出 GPT-6.1 Sol Ultrafast 和 GPT-6 Astra Ultrafast,Astra Ultrafast最高速度可达原版Astra的8倍。Pro档位每月500美元,开放更高额度,使用GPT-6.1 Sol Ultrafast可以接近Astra的能力,API开销和原版Astra基本持平。
定位总结
GPT-6 Astra仍是OpenAI综合能力最强的旗舰,适合最复杂高风险任务。而GPT-6.1 Sol主打Agent规模化落地,用大幅压低的成本,让开发者可以大规模部署编码智能体、自动化业务工作流,兼顾能力与预算,补齐了中间高性价比档位。
© 版权声明
文章版权归作者所有,未经允许请勿转载。