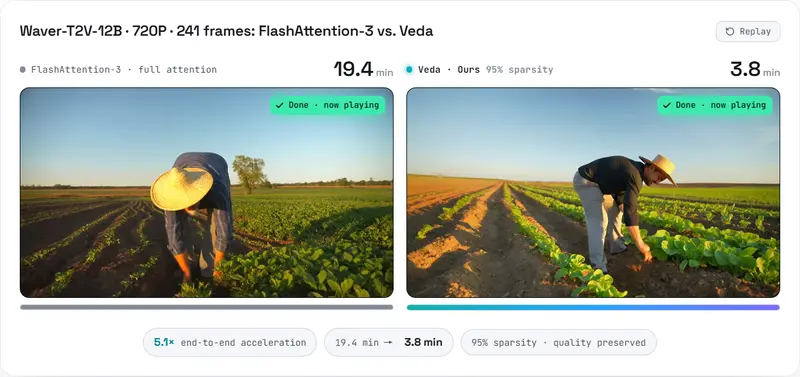
Veda 由字节跳动、香港城市大学与中国科学技术大学联合提出的一套面向视频模型的全注意力瓦片蒸馏稀疏注意力框架,目标是在尽量不损失观感的前提下,大幅降低高清长视频AI生成的算力开销。在感知质量基本保持一致的条件下最高实现90%稀疏度;720P、241帧场景,95%稀疏设置可把生成耗时从19.4分钟压缩至3.8分钟,端到端提速5.1倍。
- 项目主页:https://veda-sparse.github.io
AI视频生成的核心痛点在于,随着分辨率与总帧数上涨,时空注意力计算量会急剧膨胀。传统稀疏方案简单舍弃部分计算,极易带来画面抖动、波纹伪影、物体变形,陷入速度和画质二选一的困境。Veda由字节跳动、港城大、中科大团队联合提出,不改动原有视频生成主干,单独优化分块筛选逻辑,精准识别必须参与计算的画面区域。
核心能力
- 高清长视频推理加速:外挂插件形态,对接Waver、Wan2.1等主流开源视频模型,降低显卡负载,缩短长片段生成耗时。
- 高稀疏度保画质:激进裁剪计算量时,有效抑制帧间闪烁、扭曲这类稀疏方案典型缺陷。
- 头感知动态分块:区分空间细节、时序运动两类注意力头,为不同单元匹配专属分块策略。
- 软硬件协同优化:配套定制显卡底层运算内核,把理论算力节省落地为真实的生成速度提升。
- 低改造接入:只训练轻量预估模块,不需要从头重训完整视频底座。
局限:Veda仅为推理加速框架,无法独立生成视频,必须依附视频扩散模型;极致高稀疏场景仍有细节损失;只用于AI生成视频,不适用于实拍剪辑。
核心特点
- 将画面分块筛选作为独立蒸馏学习目标,而非生成任务附带副产品,以完整模型作为教师学习关键区域判断。
- 使用均值、最大值、最小值三重统计特征评估分块重要性,避免单纯取平均抹平关键视觉信号。
- 头感知动态分块搜索,针对不同注意力头选用适配的切割方案,减少错判。
- 专门开发硬件内核,规避很多稀疏算法“理论省算力、实际提速有限”的问题。
- 收益随视频长度提升,长时序高清场景优势更明显。
工作原理
整套框架包含统计感知分块打分预估器、头感知动态分块搜索策略、硬件分块跳过内核,采用知识蒸馏训练。
训练阶段
- 以无裁剪的原版完整视频模型作为教师,记录每一个画面分块的重要程度。
- 画面切块后,用均值、最大、最小三重特征描述每一块的信息。
- 训练轻量预估器模仿教师,预测哪些区块必须计算;训练过程隔离梯度,保护原有视频生成能力。
- 头感知分块搜索,为不同注意力头挑选最优切割方案。
- 两阶段训练:先冻结主干训练预估器;再在高稀疏条件下微调整套系统。
推理阶段
- 预估器预判画面分块优先级,标记需要保留/跳过计算的区域。
- 硬件内核直接跳过非关键区块,仅对选中区域执行注意力运算。
- 拼接各分块结果,回传给视频模型继续降噪生成。
测试结果
基于Waver-T2V、Wan2.1-T2V开展评测,结合客观指标与人眼盲测。
- 速度:720P、241帧长视频,最高5.1倍加速;帧数越高,加速收益越突出。硬件内核效率达到传统最优注意力实现的八成。
- 画质:高稀疏度下主观观感与原版接近,对比同类稀疏基线,波纹、闪烁瑕疵显著减少;降低稀疏强度,画质几乎无差别。
- 消融实验证明:三重统计特征、动态分块、蒸馏学习,三者都是保障效果的关键。
- 短板:极高裁剪比例下仍可能出现细节瑕疵;不能修复模型原生的人物崩坏、逻辑错误;消费级显卡会削弱加速上限。
未来接入该技术的AI视频模型,生成高清长视频等待时间大幅缩短,同等画质下降低对显卡性能门槛,个人创作者可在本地批量制作AI视频素材。
提醒:Veda不能根治AI视频天生的人物扭曲、逻辑崩坏问题;加速倍率越高,画质损耗风险越大,使用时需要平衡速度与画面质量。
© 版权声明
文章版权归作者所有,未经允许请勿转载。