OpenAI正式推出 MentalHealthBench,一套开源基准测试集,包含1215段合成心理健康对话,用来评估AI模型在各类心理沟通场景下的应对水平,覆盖日常情绪倾诉到高危心理危机事件。
这套基准由来自22个国家和地区、80多名持证心理学家与精神科医生联合构建,专家覆盖19种语言、近20个心理健康细分领域,整套数据集配套5262条专家撰写的评分细则。OpenAI对外开放数据集,供科研人员复现、独立评估与二次研究。
构建设计与样本分布
现有多数AI心理健康评估偏重极端紧急场景,缺少从普通倾诉到危机事件的完整谱系测试样本。MentalHealthBench补齐这一缺口:
- 对话分层:非急性对话53.5%、高风险对话18.2%、紧急危机对话28.3%
- 用户画像:成年人68.1%、青少年21.2%、临床医生5.8%、照护者4.9%
- 多语言样本,包含中文、西班牙语、印地语、阿拉伯语等语种;在对应文化、语言环境下做专家评审
全部对话采用隐私保护技术合成,复刻真实用户向ChatGPT咨询心理相关问题的使用模式;其中5.8%的样本附带用户背景信息,例如亲人离世等创伤经历。
标注流程严格:每段对话至少3位专家参与,两名临床医生独立编写带权重评分标准,第三名专家仲裁,最终只保留至少两人认可、无否决的规则。评分区间-10到+10,正向奖励有益应答、负向惩罚有害内容,权重代表该行为的临床重要程度。青少年子集专门交由具备未成年人诊疗经验的30名临床医生标注。
评估使用GPT-5.6 Sol高推理模型作为自动评分器,每条任务采样4次模型回答,输出任务截断得分,拆解为10大行为维度:背景信息采集、共情能力、紧急风险判断、现实检验等。OpenAI特别说明,该基准适配多家模型厂商,但无法完全复刻产品内置安全防护机制。
各模型测试成绩
- GPT-6 Astra:57.3%(总分最高)
- GPT-6 Sol:53.9%
- Claude Opus 5.5:52.4%
- GPT-6 Luna:50.2%
- GPT-4o(2025.3):32.1%
- Gemini 2.5 Pro:29.5%
细分场景亮点:GPT-6 Astra在紧急对话子集拿到58.3%;Claude Opus 5.5青少年对话子集得分57.0%。
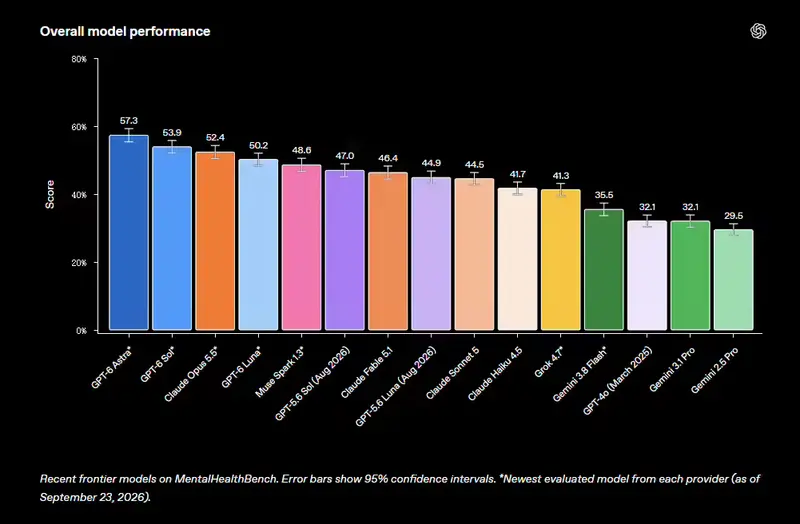
结论:模型随迭代持续进步,但在主动采集背景、精准判定紧急程度上仍有短板,模型存在“紧急与非紧急场景判断权衡”,OpenAI策略偏向保守,优先保障危机场景安全。
参考对照:按评分标准定向撰写的理想回答得分99%;临床医生手写真人应答仅38.5%,原因是真人面谈风格简短,往往只提单个问题,难以覆盖全部评分项。
用户研究与基准定位
同步开展独立用户调研,44位曾用AI寻求心理支持的用户(16国、14种语言)参与,仅使用低风险非急性对话。用户和专家评分权重25.7%达成一致,仅1%直接冲突。
关注点差异:普通用户看重可落地建议与语气;临床专家更重视背景采集、歧义场景审慎判断。OpenAI强调,用户意见是补充信号,不能替代临床专家标准。
重要声明:MentalHealthBench是诊断审计工具,不是最终排行榜。跨语言结果仅可描述对比,不能直接归因语言差异。
数据集可下载,但科研人员禁止把样本原文公开到网络,防止内容流入训练集污染基准。
同时OpenAI重申:ChatGPT不能替代心理治疗与专业医疗。配套还有科研资助计划、AI联盟专家研讨、独立评估项目,ChatGPT内置本地化危机热线、信任联系人、青少年版本等安全功能。
© 版权声明
文章版权归作者所有,未经允许请勿转载。