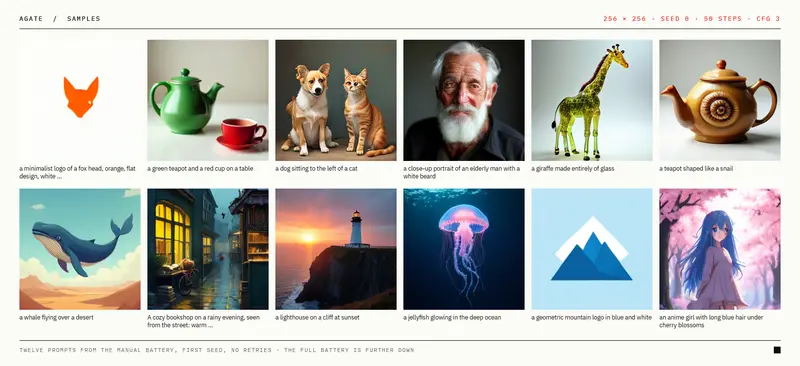
SupraLabs 推出 Supra2-IMG,一个仅含 1.05 亿参数的微型文本到图像扩散 Transformer(DiT),在高质量合成数据集 LucasFang/FLUX-Reason-6M 上训练 10 个 epoch 后,为其参数规模提供了当前最先进的图像生成质量。
- 模型:https://huggingface.co/SupraLabs/Supra2-IMG
模型使用冻结的 Flan-T5-Base 作为文本编码器、SD-VAE-FT-MSE 作为 VAE,原生分辨率为 256×256,latent 空间为 32×32。整个训练过程(含数据准备)在单张 Nvidia H100 SXM 80GB 上仅耗时 9 小时,体现了“小团队+有限硬件”下的高效研究范式。
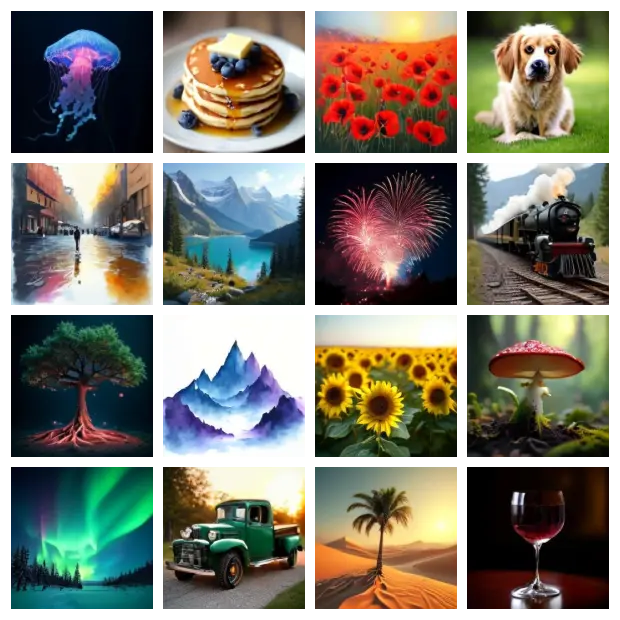
技术规格与架构设计
| 组件 | 配置 |
|---|---|
| 总参数量 | 104.1M |
| DiT 深度 | 14 层 |
| 隐藏维度 (D_MODEL) | 576 |
| 注意力头数 / 头维度 | 9 / 64 |
| MLP 扩展比 | 4.0 |
| 文本上下文长度 | 128 tokens (Flan-T5-Base) |
| VAE 缩放因子 | 0.18215 |
| Patch 大小 | 2 |
| 输出分辨率 | 256² |
该架构刻意保持紧凑:14 层 DiT + 576 维隐藏层在 1 亿参数约束下最大化容量效率。Flan-T5-Base 虽非最新文本编码器,但其 768 维输出与 DiT 的 D_CTX=768 直接对齐,避免投影层开销。SD-VAE-FT-MSE 是 Stable Diffusion 生态验证过的轻量 VAE,确保 latent 表示稳定。
数据策略:质量优先的合成数据管线
Supra2-IMG 的核心创新不在架构,而在数据筛选逻辑。训练集 FLUX-Reason-6M 包含 560 万张合成图像,每张附带多级 caption。数据准备采用严格优先级回退机制:
caption_composition → caption_entity → caption_text → caption_style → caption_imaginative
这意味着:
- 优先使用描述构图结构的 caption(最高信息密度)
- 仅当上级缺失时,才降级到实体、文本、风格等次级描述
- 完全过滤低质量或模糊提示词
这种策略确保模型在预训练阶段只接触高信噪比的图文对,弥补了小模型的容量劣势。10 个 epoch 的训练时长也表明数据质量足以支撑充分收敛,无需过度迭代。
训练效率:H100 单卡 9 小时全流程
- 硬件:单张 H100 SXM 80GB + 2.5TB 本地存储
- 总耗时:9 小时(含数据下载、清洗、训练)
- 吞吐量估算:约 17,000 步/小时(假设 batch size 适配显存)
这一效率得益于:
- 微型模型本身计算开销低
- 合成数据无需复杂预处理(如人脸检测、美学评分)
- Parquet 格式元数据支持流式加载,避免内存瓶颈
- Flan-T5 冻结,省去编码器梯度计算
对于独立研究者,这证明了在消费级云算力(RunPod Pod)上完成前沿 T2I 实验的可行性。
定位与边界认知
适用场景:
- 教育与研究:理解 DiT 架构、数据筛选策略、小模型训练动力学
- 边缘部署原型:1 亿参数可在高端手机/嵌入式 GPU 上实时推理
- 合成数据管线验证:测试新 caption 生成方法的效果
- 快速概念验证:256px 草图生成,后续用大模型精修
明确局限:
- 分辨率限制:256² 原生输出,放大至 512+ 需额外超分,细节损失显著
- 文本理解上限:Flan-T5-Base + 128 token 上下文难以处理复杂指令或多对象关系
- 生成多样性:小模型 + 合成数据可能导致模式坍缩,真实感弱于 FLUX/SDXL
- 非生产就绪:无安全过滤、无 LoRA 微调支持、无社区生态
与其他微型 T2I 模型的对比
| 模型 | 参数量 | 分辨率 | 数据源 | 训练成本 | 特点 |
|---|---|---|---|---|---|
| Supra2-IMG | 104M | 256² | 合成 (FLUX-Reason-6M) | H100×9h | 数据筛选优先,SOTA for scale |
| BK-SDM | 300M+ | 256–512 | LAION/COCO | 多卡×天级 | 蒸馏自 SD,通用性强 |
| Tiny-Diffusion | 50M | 64–128 | CIFAR/ImageNet | RTX3090×小时级 | 教学导向,极低分辨率 |
| MobileDiffusion | 800M | 512 | 私有数据 | 未公开 | Google 端侧优化,闭源 |
Supra2-IMG 的独特价值在于:在 100M 参数级别,首次通过纯合成数据+智能筛选达到可用质量门槛,而非依赖蒸馏或真实数据。这为“数据效率 > 模型规模”提供了实证。
负责任使用提醒
- 合成数据偏见:FLUX-Reason-6M 由 AI 生成,可能继承上游模型的刻板印象;输出需人工审核
- 非商业用途:SupraLabs 定位为教育/实验,未声明商业许可;使用前确认条款
- 分辨率预期管理:勿将 256px 输出与大模型 1024px 结果直接比较
- 研究复现:代码与数据开源,但 H100 环境差异可能导致结果波动;建议记录完整训练日志
© 版权声明
文章版权归作者所有,未经允许请勿转载。