Nums AI 正式发布了 Causilo,一款专为分类和回归任务设计的预训练表格基础模型。凭借其创新的上下文学习架构,Causilo 在权威基准测试 TabArena 中取得了单一模型(Single Model)类别的最高 Elo 评分,标志着表格数据 AI 领域的又一重要进展。
- GitHub:https://github.com/nums-ai/causilo
- 模型:https://huggingface.co/nums-ai/causilo
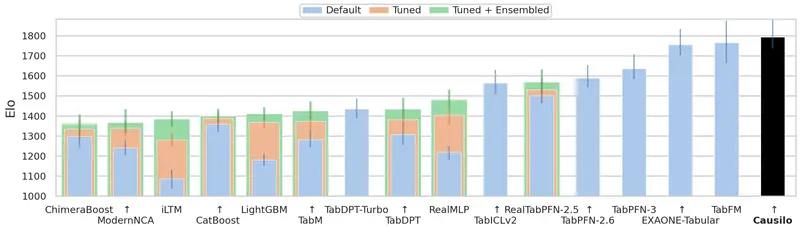
核心成就:TabArena 领跑者
在包含 51 个数据集和 816 个完整拆分的 TabArena 评估中,Causilo 表现卓越:
| 任务类型 | Causilo Elo | 次佳单一模型 | 领先优势 |
|---|---|---|---|
| 总体 (Overall) | 1792.9 | TabFM (1764.4) | +28.5 |
| 分类 (Classification) | 1771.8 | EXAONE Tabular (1758.8) | +13.0 |
| 回归 (Regression) | 2032.6 | TabFM (1992.8) | +39.8 |
注意:若包含集成系统(Ensemble Systems),Causilo 在 88 个条目中排名第 3。但在单一模型对比中,它超越了 Google Research 的 TabFM、LG AI Research 的 EXAONE Tabular 以及 Prior Labs 的 TabPFN-3。
此外,在 ScoringBench(使用 CRPS、RMSE 和 R² 评分)的 101 个数据集测试中,Causilo 同样位列第一。
技术架构:细化、压缩与上下文学习
Causilo 采用了一种高效的三阶段架构,旨在平衡性能与计算成本:
- 特征嵌入与细化 (Refinement):
- 特征以 3 个为一组进行处理。
- 每个值通过 16 个学习的正弦/余弦频率进行嵌入,缺失值拥有独立的学习向量。
- 列与行交互 (Compression):
- 列阶段:使用 128 个潜在槽位总结特征组,仅读取训练行信息。
- 行阶段:通过 4 个潜在令牌让特征组之间交互。关键在于使用交叉注意力 (Cross-Attention) 而非全自注意力,使得计算成本与特征数量呈线性关系,极大提升了处理宽表的能力。
- 上下文学习预测 (Context Learning):
- 每行被压缩为固定的 512 维向量。
- 标签被添加到训练行上下文中。
- 一个 12 层的预测块让查询行关注带标签的训练行,但查询行无法改变训练上下文或彼此,确保了推理的稳定性。
- 默认采用 8 个集成成员,共享权重但使用不同的归一化策略(none, rank2gaussian, robust, power)和种子排列。
性能与效率
在单张 H100 80GB GPU 上的测试显示,Causilo 在速度和内存占用上具有显著优势:
| 模型 | 拟合速度 (秒/千行) | 预测速度 (秒/千行) | GPU 内存 (GiB) |
|---|---|---|---|
| Causilo | 2.504 | 0.251 | 8.15 |
| TabICLv2 | 3.449 | 0.303 | 8.37 |
| TabPFN-3 | 4.18 | 0.686 | 0.88 |
- 速度最快:在拟合和预测阶段均优于 TabICLv2 和 TabPFN-3。
- 内存优化:虽然比 TabPFN-3 占用更多显存,但通过设置
use_kv_cache=True可以加速重复预测。
功能亮点
- Scikit-learn 接口:无缝集成到现有的 Python 机器学习工作流中,调用
fit不会更新预训练权重,而是将训练行存储为上下文。 - 灵活输入:支持 NumPy 数组和 Pandas DataFrame,自动处理分类特征(最多 10 个类别)和缺失值。
- 高级回归输出:版本 1.0.1 增加了基于 999 个原生分位数的中位数和分位数输出,开箱即用提供预测区间。
- 纯合成数据预训练:模型仅在合成数据上预训练,未见过任何 TabArena 真实数据集,证明了其强大的泛化能力。
© 版权声明
文章版权归作者所有,未经允许请勿转载。