edge0 是一个专为边缘设备和消费级硬件设计的开源流式 MoE(混合专家)推理框架。它通过将 SSD 专家卸载、Recover-LoRA 和 Prerouter 路由预判 三大核心技术抽象为通用架构,成功打破了大模型对显存的强依赖。
- GitHub:https://github.com/Edge0-AI/Edge0
- Hugging Face:https://huggingface.co/Edge0/Edge0-35B-A3B-preview
- Hugging Face:https://huggingface.co/Edge0/Edge0-8B-A1B-preview
- 魔搭:https://modelscope.cn/models/Edge0/Edge0-35B-A3B-preview
- 魔搭:https://modelscope.cn/models/Edge0/Edge0-8B-A1B-preview
目前框架首发 MLX 后端(Apple Silicon),并随附两个开箱即用的模型档位:Edge0-35B-A3B 与 Edge0-8B-A1B。两者均以 int4 量化形式发布,并捆绑了专门训练的 LoRA 适配器与 Prerouter 权重,实现了“下载即跑”的完整管线体验。
三大核心技术机制
edge0 之所以能在极低内存下保持高速度和质量,依赖于以下三项协同工作的技术:
- SSD 专家卸载 (Expert Offloading)
- 专家权重不常驻内存,而是按需从存储设备(NVMe/闪存)流式加载。
- RAM 中仅保留当前激活的专家权重,峰值内存由活跃集决定而非总参数量。
- Prerouter 路由预判
- 一个轻量级训练头提前一步预测下一层的专家路由。
- 使专家加载与前向计算重叠,消除 I/O 阻塞,解码吞吐量最高提升 +59%。
- Recover-LoRA 质量恢复
- 冻结 int4 基础模型,通过蒸馏 FP 教师模型训练 LoRA 适配器。
- 在 4-bit 精度下恢复大部分量化损失,且适配器未合并,支持一个只读基座服务多组适配器。
模型档位对比
| 特性 | Edge0-35B-A3B-preview | Edge0-8B-A1B-preview |
|---|---|---|
| 基础模型 | Qwen3.6-MoE 35B-A3B | Ling 3.0 tiny (百灵混合架构) |
| 活跃内存 | < 3 GiB | < 1 GiB |
| 解码速度 | 15 tok/s | 25 tok/s |
| Prefill (热) | 140 tok/s | 1428 tok/s |
| 层数 / 专家数 | 40层 / 256专家 (K=4) | 24层 / 128专家 (K=8) |
| 上下文长度 | 标准 | 128k |
| 质量损失 (vs fp16) | 平均 -3.9 分 | 平均 -2.8 分 (MMLU-Pro 反超) |
| 许可证 | Apache 2.0 | Apache 2.0 |
测试环境:Mac mini M4 Pro (24GB),使用
examples/bench.py测量。长上下文会增加 KV 缓存占用。
核心优势与使用场景
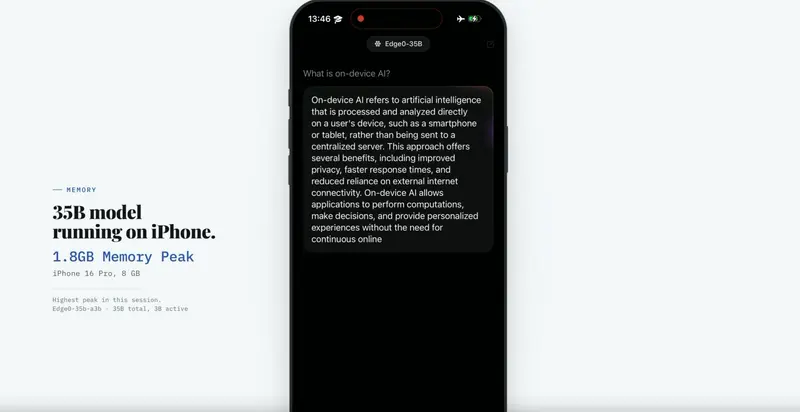
- 手机级内存运行大模型:35B 模型仅需 3GiB,8B 模型仅需 1GiB,无需分片或全量加载。
- 单卡批量服务:一个只读基础模型可同时挂载多组 LoRA 适配器,无需重复量化或加载基座。
- 高质量低比特推理:Recover-LoRA 确保 int4 模型在 AIME、HumanEval、GPQA 等基准上接近甚至超越 fp16 原版。
- 开箱即用:
edge0 serve <tier>一条命令启动,适配器与 Prerouter 自动加载。 - 思考模式支持:内置聊天模板,支持多语言对话与深度推理。
⚠️ 当前局限性
- 预览阶段:覆盖范围和质量仍在扩展中,主要针对基座模型支持的语言调优。
- 智能体能力较弱:工具调用、多步规划和长周期自主任务尚未优化,完整版将大幅增强。
- 后端限制:当前仅支持 MLX (Apple Silicon),CUDA 等其他后端已在路线图中。
- 长上下文开销:虽然基座内存占用极低,但长上下文会显著增加 KV 缓存,建议根据实际 RAM 控制上下文长度。
© 版权声明
文章版权归作者所有,未经允许请勿转载。