腾讯混元团队正式推出 Hy4 preview 轻量版,依靠自研低比特量化技术,将原版接近 1.5TB 的模型权重压缩至约 214GB,大幅降低本地部署门槛;同时验证跨局域网异构设备联合推理方案,普通开发者也有机会运行这款旗舰级混合专家大模型。
- 模型:https://huggingface.co/AngelSlim/Hy4-preview-GGUF
回顾基础参数,Hy4 preview 是8月28日开源的新一代 MoE(混合专家)基座:总参数量 770B(7700亿),推理激活参数 49B,原生支持 100万 Token超长上下文窗口。原版BF16权重体积巨大,对硬件要求极高。
两大自研压缩技术
1、Sherry 稀疏三值量化算法
专门针对路由‑专家层优化,实现平均 1.25比特 权重存储;将四个权重打包为一组,硬件SIMD指令友好,兼顾压缩密度与推理速度。
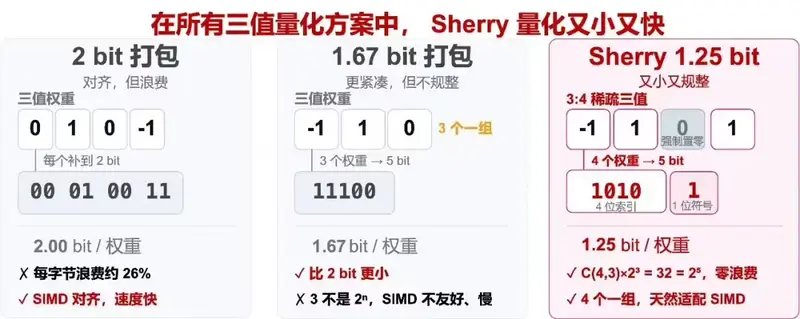
2、MIX‑STQ1_0 混合精度分层策略
不再全模型一刀切使用相同比特位。基于校准数据识别网络当中不同层级的敏感度:
- 敏感层:保留较高精度,2.06 比特(IQ2_XXS)
- 不敏感层:激进压缩,STQ1_0,1.31比特
分层量化,在存储空间与模型效果之间取得平衡。
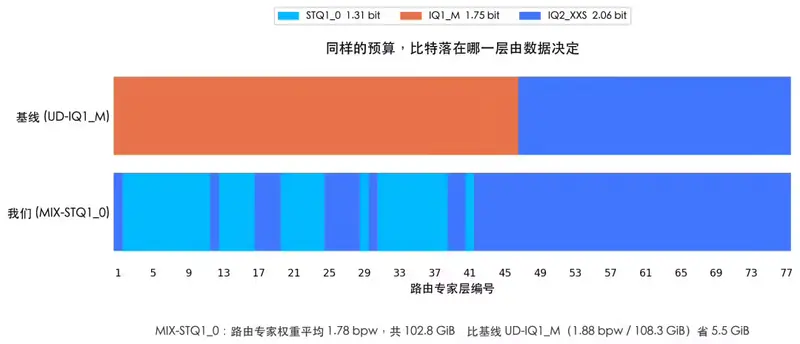
压缩后性能损失极小
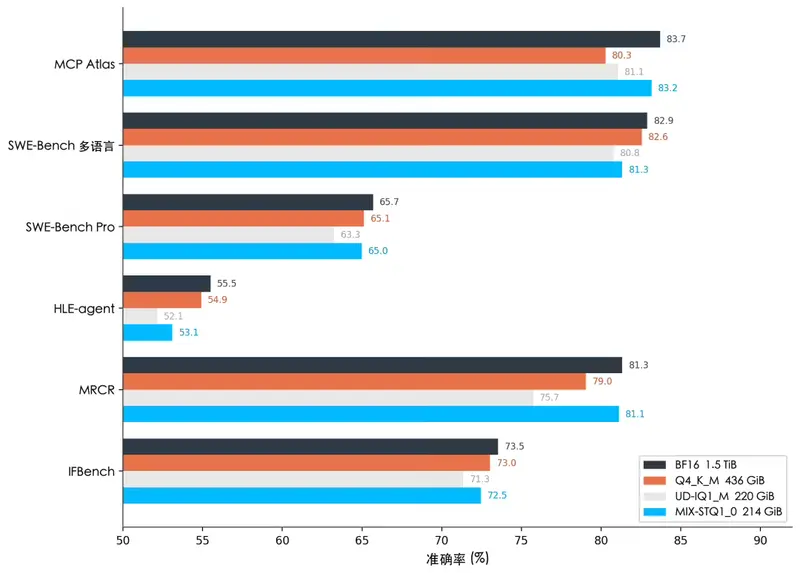
对比 BF16原版模型评测结果:
- 长文理解、百万Token多轮检索能力几乎持平
- 数学、代码能力仅有小幅回落
- MCP‑Atlas:83.7 → 83.2
- SWE‑Bench multi:82.9 → 81.3
整体能力足以覆盖长文档分析、代码开发、智能体任务、复杂问答等生产力场景。
异构跨局域网联合推理方案落地
混元团队联合 prima.cpp 完成拆分推理验证:
硬件组合:RTX 4090笔记本 + 四卡A4000服务器,两台设备处于不同局域网,合计显存80GB、内存64GB。
依靠异构调度拆分MoE专家层,协同推理速度可达 1.02 token/s,对比笔记本单机内存卸载运行提速大约 6倍。
这代表开发者不必单台机器拥有超大显存,多台现有机器拼接就可带动214GB轻量版模型。
部署生态
轻量版权重现已上架 Hugging Face、GitHub;
兼容 llama.cpp、vLLM、SGLang 主流推理框架,量化GGUF推理内核代码同步开源。
© 版权声明
文章版权归作者所有,未经允许请勿转载。