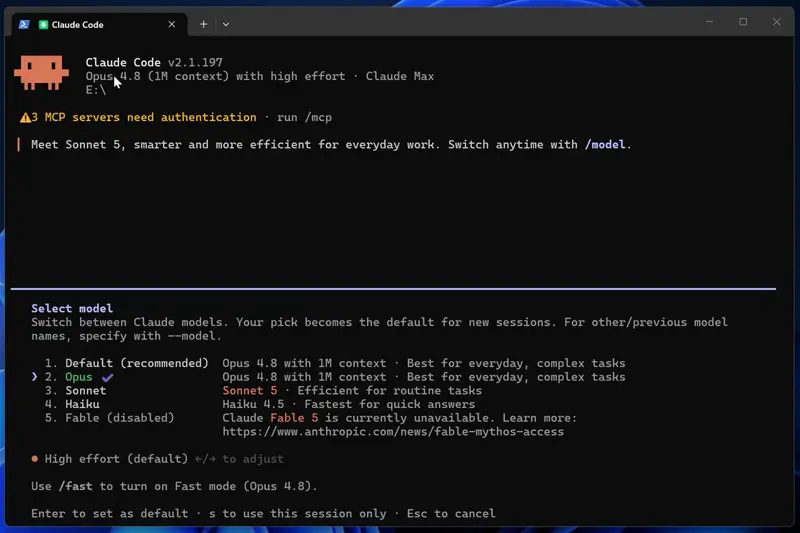
Anthropic 正式推出了 Claude Sonnet 5,这是一款旨在重塑性价比格局的新一代模型。其核心突破在于将原本仅限于顶级 Opus 系列的“智能体(Agentic)”能力——如自主规划、工具调用和自我验证——下放到了更亲民的 Sonnet 层级。
- 官方介绍:https://www.anthropic.com/news/claude-sonnet-5
对于开发者和企业用户而言,Sonnet 5 意味着可以用显著更低的成本,获得接近 Opus 4.8 的复杂任务处理能力,尤其是在编码、自动化工作流和深度研究场景中。
核心升级:从“对话者”到“执行者”
Sonnet 5 被官方定义为“迄今为止最具 Agentic 能力的 Sonnet 模型”。与前辈相比,它在处理多步骤任务时表现出了质的飞跃:
- 自主规划与工具使用:能够独立制定执行计划,并熟练调用浏览器、终端等外部工具。
- 自我验证机制:在未被明确要求的情况下,模型会主动检查自己的输出结果,大幅减少了代码错误或逻辑漏洞。
- 复杂任务闭环:测试人员反馈,Sonnet 5 能够完成以前 Sonnet 模型容易中途放弃的长链条任务,表现出更强的韧性和完整性。
性能与基准:缩小与 Opus 的差距
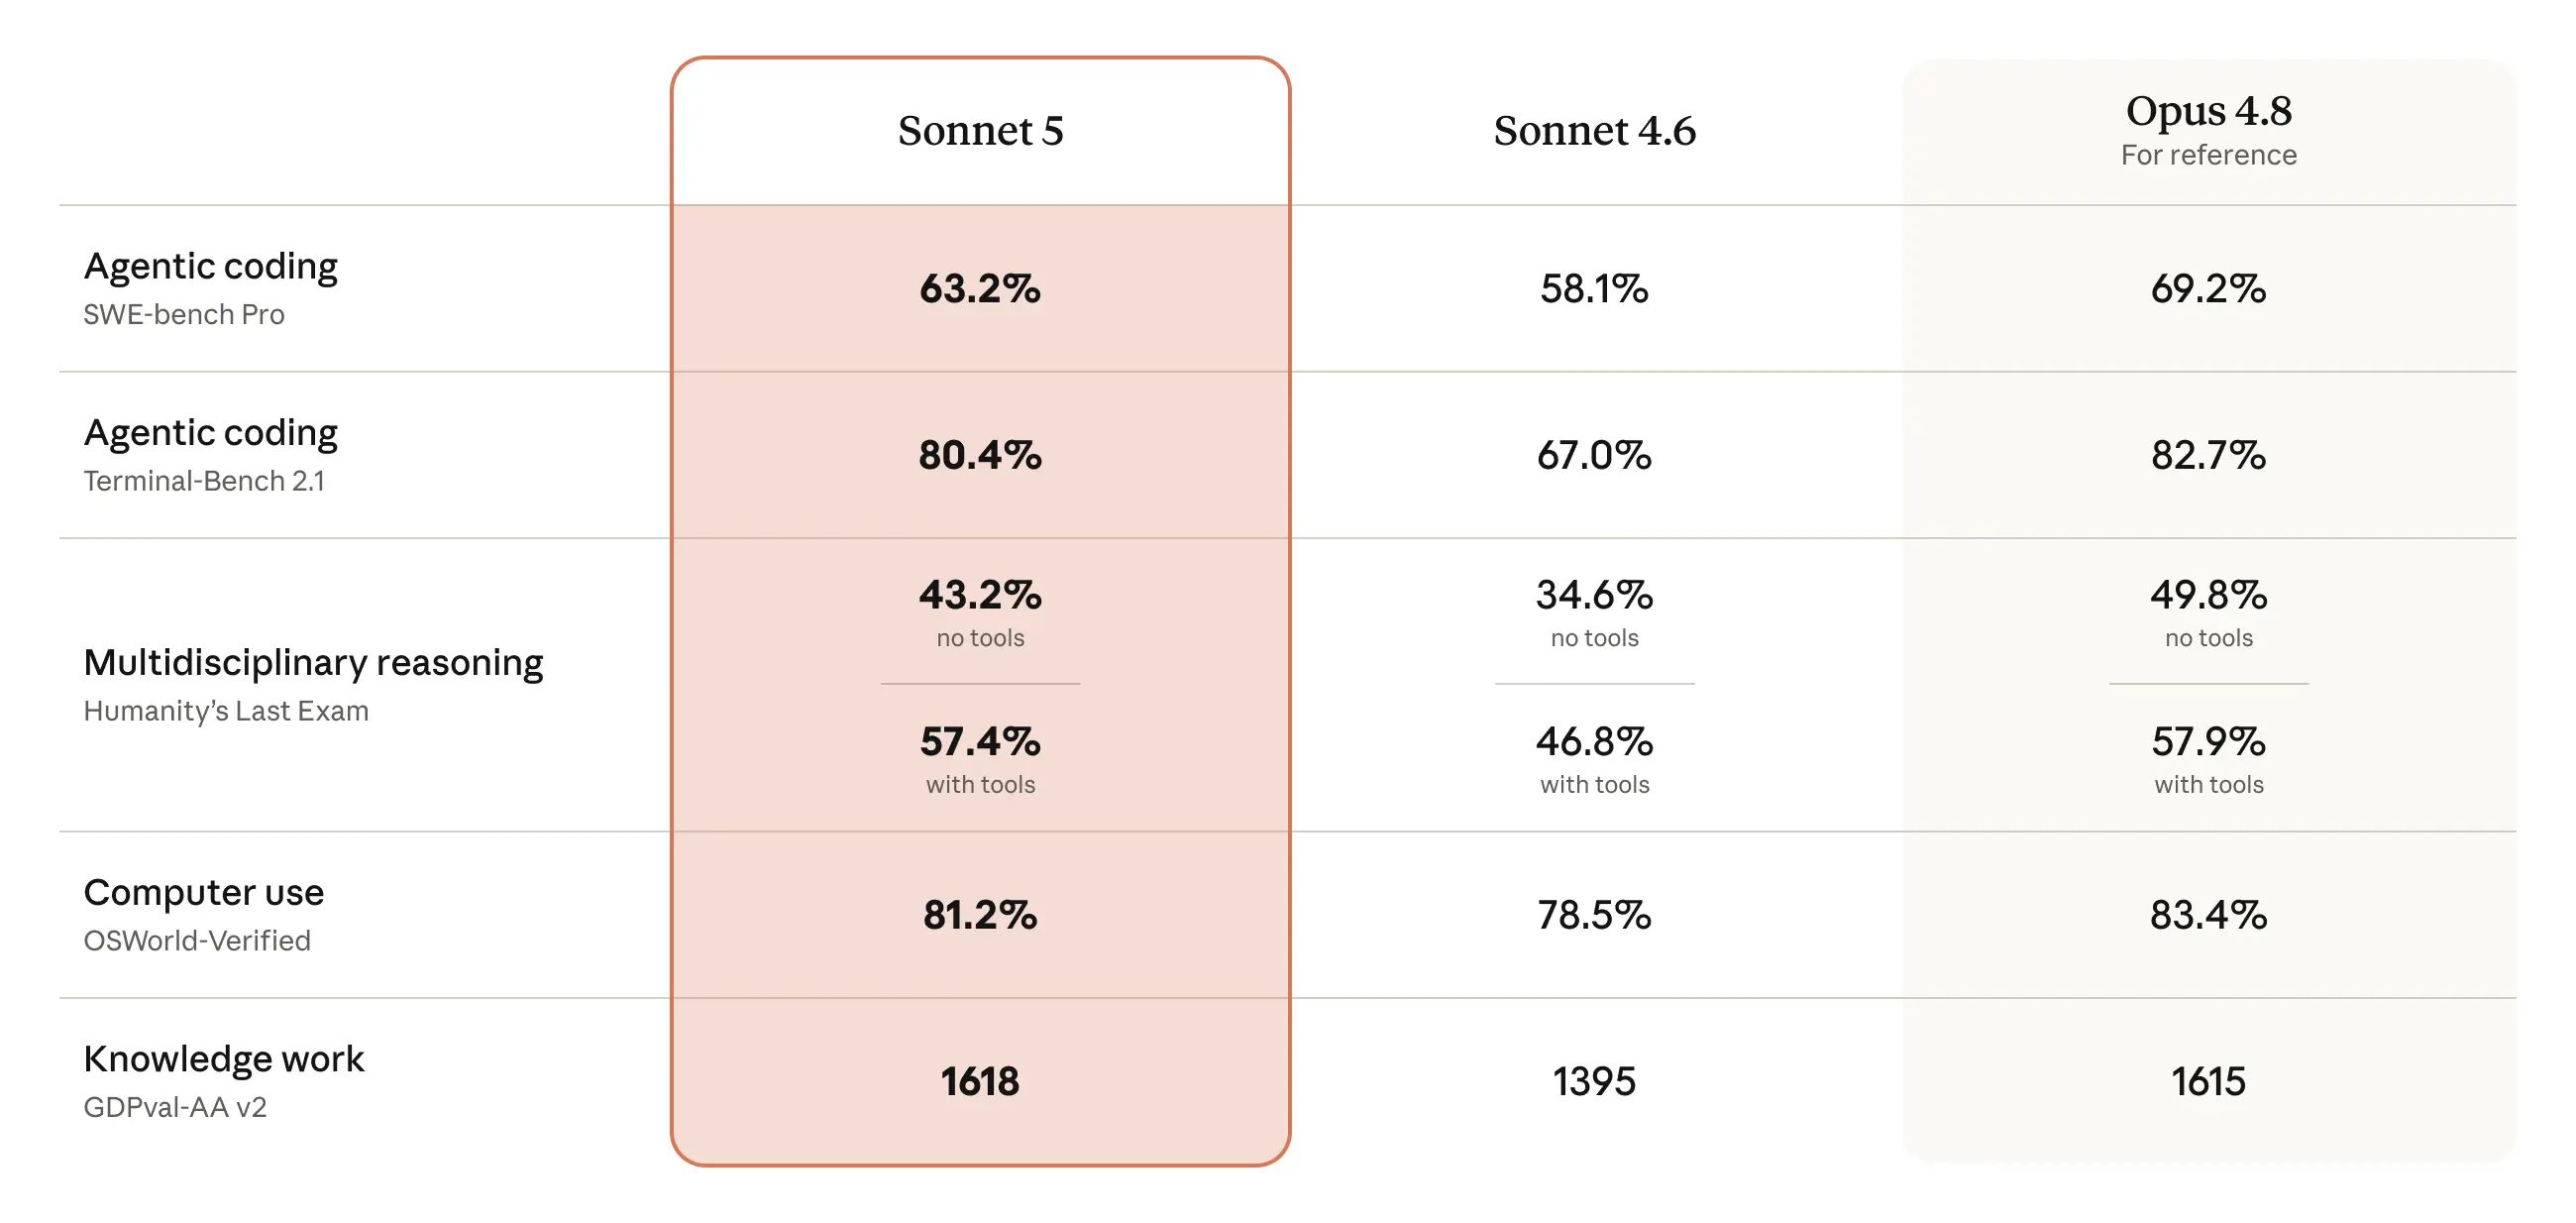
在 BrowseComp(智能体搜索评估)和 OSWorld-Verified(计算机使用评估)等权威基准测试中,Sonnet 5 的表现远超 Sonnet 4.6,并在中等努力水平下展现出极高的成本效率。在某些高难度任务上,通过调整“努力水平”,Sonnet 5 的性能甚至可以匹配 Opus 4.8。
| 特性 | Sonnet 4.6 | Sonnet 5 | Opus 4.8 |
|---|---|---|---|
| Agentic 能力 | 基础 | 显著增强 | 顶级 |
| 工具调用 | 有限 | 熟练 | 精通 |
| 自我验证 | 弱 | 强 | 极强 |
| 适用场景 | 简单问答、短代码 | 自动化、复杂编码 | 极致推理、科研 |
安全评估:更稳健,但保留防护栏
Anthropic 的安全评估显示,Sonnet 5 在拒绝恶意请求和抵御提示注入方面优于 Sonnet 4.6,幻觉率和谄媚率也有所下降。
值得注意的是,虽然 Sonnet 5 的通用智能有所提升,但其在潜在危险的网络安全任务(如开发漏洞利用代码)上的能力仍远不及 Opus 4.8 或 Mythos 5。为了平衡能力与安全,Anthropic 已为 Sonnet 5 默认启用了与 Opus 系列相同的网络安全防护措施。
定价策略:极具竞争力的入门价
为了推广 Sonnet 5,Anthropic 推出了限时优惠定价,使其成为目前市场上性价比最高的智能体模型之一:
- 促销期定价(有效期至 2026 年 8 月 31 日):
- 输入:$2 / 百万 tokens
- 输出:$10 / 百万 tokens
- 标准定价(2026 年 9 月 1 日起):
- 输入:$3 / 百万 tokens
- 输出:$15 / 百万 tokens
相比之下,Opus 4.8 的标准定价为输入 $5 / 百万 tokens,输出 $25 / 百万 tokens。这意味着在促销期内,Sonnet 5 的成本仅为 Opus 4.8 的 40% 左右。
可用性与集成
Sonnet 5 现已全面开放:
- 个人用户:Free、Pro 和 Max 订阅用户均可使用,其中 Free 和 Pro 计划将其设为默认模型。
- 开发者:可通过 Claude API 调用
claude-sonnet-5,并已集成至 Claude Code、Cowork 等平台。 - 速率限制:Anthropic 已提高了相关平台的速率限制,以支持更高努力水平下的 Token 消耗。
© 版权声明
文章版权归作者所有,未经允许请勿转载。