DeepSeek 与北京大学近日联合发布了 DSpark 推理加速框架,旨在解决大语言模型(LLM)在生产环境中面临的高并发推理效率瓶颈。该框架通过创新的“半自回归”候选生成机制与“置信度调度验证”策略,在无损生成质量的前提下,显著提升了推理吞吐量与响应速度。目前,DSpark 已部署于 DeepSeek-V4-Flash 与 DeepSeek-V4-Pro 的预览版服务引擎中,相关代码与论文已在 GitHub 开源。
- GitHub:https://github.com/deepseek-ai/DeepSpec
- DeepSeek-V4-Pro-DSpark:https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-DSpark
- DeepSeek-V4-Flash-DSpark:https://huggingface.co/deepseek-ai/DeepSeek-V4-Flash-DSpark
核心突破:平衡“接受率”与“生成延迟”
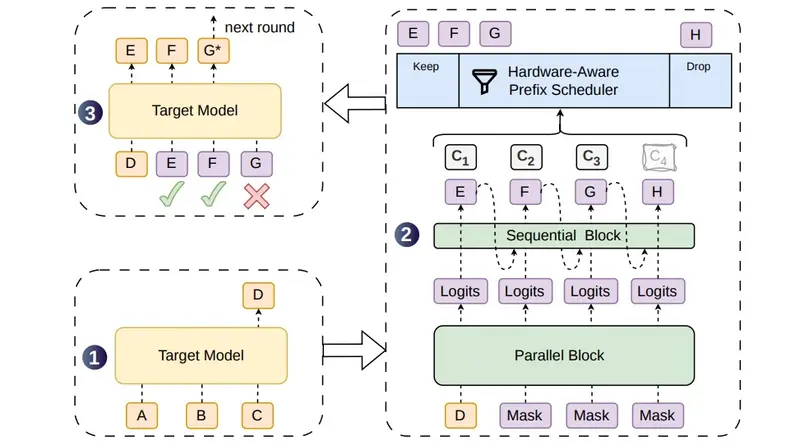
传统的推测解码(Speculative Decoding)技术受限于草稿模型的生成质量与验证阶段的资源占用。DSpark 针对现有方案的痛点,提出了两项互补的核心机制:
1. 半自回归架构:兼顾容量与依赖
DSpark 摒弃了纯并行或纯自回归的极端选择,采用了一种混合架构:
- 并行主干:基于改进的 DFlash,一次性产出所有候选位置的隐藏状态和基础 logits,保留并行计算的高效性。
- 顺序模块:引入轻量级的马尔可夫头或 RNN 头,逐 token 注入前缀依赖信息。
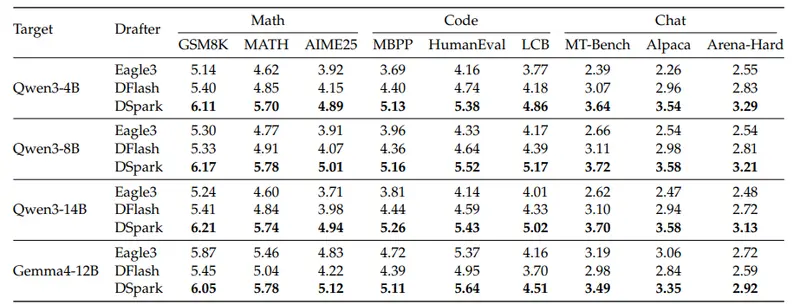
- 效果:实验显示,仅两层 Transformer 深度的 DSpark 即可在所有测试领域上超越五层 DFlash 的接受长度,以极低的参数成本实现了更高的候选接受率。
2. 置信度调度验证:动态分配计算资源
为解决固定长度验证导致的资源浪费问题,DSpark 引入了硬件感知的动态调度:
- 置信度校准:模型为每个候选 token 输出一个置信度分数,预测其被接受的概率。
- 全局优化:调度器根据并发请求的置信度分布及引擎吞吐量曲线,动态决定每个请求的验证前缀长度,优先将计算资源分配给存活概率最高的 token。
- 异步执行:通过异步模式隐藏调度延迟,兼容 CUDA 图重放等高性能工程约束,确保 GPU 流水线不停滞。
性能实测:吞吐量与速度的双重飞跃
在离线基准测试与在线生产环境实测中,DSpark 均表现出显著优势:
| 场景 | 对比基线 | 提升幅度 | 备注 |
|---|---|---|---|
| 离线基准 (Qwen3-4B) | Eagle3 (自回归) | +30.9% | 平均每轮接受长度 |
| 离线基准 (Qwen3-4B) | DFlash (并行) | +16.3% | 平均每轮接受长度 |
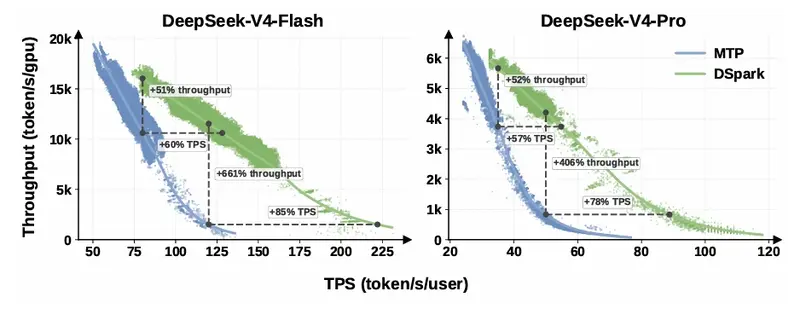
| V4-Flash 引擎 (SLA 80 tok/s) | MTP-1 (单 token) | +51% | 聚合吞吐量 |
| V4-Flash 引擎 (SLA 120 tok/s) | MTP-1 (单 token) | +661% | 高负载下优势巨大 |
| V4-Pro 引擎 (SLA 35 tok/s) | MTP-1 (单 token) | +52% | 聚合吞吐量 |
| 单用户生成速度 | MTP-1 (单 token) | 60% – 85% | 同等吞吐量水平下 |
工程优化:从理论到落地的关键
为了适应真实的生产环境,研究团队在系统集成中实施了多项工程优化:
- 通信降维:并行训练时仅传递目标模型的隐藏状态而非完整词表 logits,将通信复杂度从 $O(V)$ 降至 $O(d)$。
- 密集批次打包:采用锚点定长序列打包策略,避免传统填充带来的计算和内存开销。
- 解耦物理执行与逻辑跟踪:将所有 token 展平为独立元素处理,通过稀疏注意力中的标记张量传递依赖关系,支持动态变长验证前缀。
© 版权声明
文章版权归作者所有,未经允许请勿转载。