随着人工智能模型规模的指数级增长,传统数据中心网络架构已难以支撑数十万甚至百万级 GPU 集群的高效协同训练。网络拥塞、链路故障导致的 GPU 空转和训练中断,成为制约算力释放的最大瓶颈。
- 官方介绍:https://openai.com/index/mrc-supercomputer-networking
OpenAI 联合 AMD、微软、英伟达、博通、英特尔 等行业巨头,通过开放计算项目(OCP)正式发布 多路径可靠连接协议(MRC, Multipath Reliable Connection)。这一全新网络协议旨在通过多路径并行传输、微秒级自动绕行和静态源路由技术,彻底消除大规模 AI 训练中的网络不确定性,为即将到来的 Stargate 超级计算机项目 奠定坚实基础。
核心突破:为何 MRC 是革命性的?
1. 多平面网络架构:化整为零,天然冗余
MRC 摒弃了传统单一高速链路(如单条 800Gb/s)的设计,转而将单个网络接口拆分为多条低速子链路(如 8 条 100Gb/s),分别连接不同的交换机,构建多平面网络。
- 层级简化:仅需两层交换机即可覆盖约 13.1 万块显卡的全互联网络,而传统架构需三至四层。
- 成本与功耗双降:更少的交换机层级意味着更低的硬件成本、功耗和延迟。
- 本地流量优化: 更多流量可在零层级交换机内本地流转,提升整体吞吐效率。
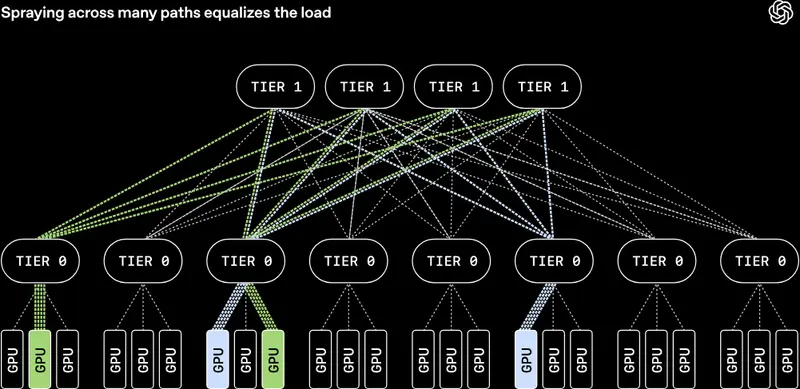
2. 自适应数据包分发:数百路径并行,消除拥塞
传统协议要求单次传输固定单一路径以保序,极易引发拥塞。MRC 重构了这一模式:
- 并行传输:将单次传输的数据包拆分,分散至数百条路径、所有独立网络平面并行发送。
- 无需保序:接收端根据数据包携带的目标内存地址随到随存,无需等待按序抵达。
- 智能负载均衡:实时检测路径状态,一旦某条路径拥塞,立即切换至其他路径,均衡全网负载。
3. 微秒级故障自愈:静态源路由取代动态路由
MRC 引入 IPv6 分段路由(SRv6) 技术,用静态配置取代复杂的动态路由协议(如 BGP):
- 源路由机制:发送端直接在数据包中指定完整传输路径(交换机标识序列)。
- 快速绕行:检测到路径故障或丢包时,MRC 在微秒级时间内停用该路径并切换,无需交换机重新计算路由。
- 数据包裁剪:若因拥塞即将丢包,交换机仅转发头部触发重传,避免误判为路径故障,减少不必要的路径切换。
实际落地效果:从“脆弱”到“坚韧”
在 OpenAI 现有的英伟达 GB200 超级计算机集群(包括甲骨文云和微软费尔沃特节点)中,MRC 已展现出卓越的性能:
| 场景 | 传统网络表现 | MRC 协议表现 |
|---|---|---|
| 链路波动 | 每分钟多次波动可能导致训练中断或大幅降速 | 无感运行,性能损耗微乎其微 |
| 交换机重启 | 需协调停机,训练任务暂停数秒至数分钟 | 无需报备,常规维护期间训练持续进行 |
| 端口故障 | 单端口故障可能导致整个接口失效,训练崩溃 | 速率仅降 1/8,自动规避故障平面,一分钟内自愈 |
| 路由收敛 | 动态路由重构需数秒至数十秒 | 微秒级切换,静态路由表无需变更 |
三大核心优势总结
- 极简架构,超大规模:仅用两层交换机即可构建支持超 10 万块显卡的高速网络,功耗低于传统三层/四层架构。
- 零拥塞,高稳定:自适应负载均衡消除核心网络拥塞,大幅降低同步训练中的吞吐量波动,确保多任务共享集群时无性能干扰。
- 静态控制,高可靠:基于 SRv6 的静态源路由彻底规避动态路由引发的隐性故障,实现故障节点的快速绕过与无缝恢复。
行业意义:开源开放,共建未来
MRC 协议的发布不仅是 OpenAI 算力战略的重要一环,更是整个 AI 基础设施行业的里程碑。通过 OCP 开源,MRC 将成为跨厂商、跨平台的标准规范,促进更广泛的生态兼容。
对于正在构建下一代大模型训练集群的企业和研究机构而言,MRC 提供了一套经过实战验证的高可靠性网络蓝图。它证明了在超大规模算力部署中,高可靠性与高效率并非不可兼得,而是可以通过架构创新实现完美统一。
© 版权声明
文章版权归作者所有,未经允许请勿转载。