在图像生成领域,扩散模型长期占据主导地位。但 Luma AI 推出的 Uni-1 正在打破这一常规。作为一个仅解码器的自回归变换器(Decoder-only Autoregressive Transformer),Uni-1 不直接预测像素噪声,而是将文本和图像视为统一的序列进行建模。
- API:https://lumalabs.ai/api
现在,Uni-1 已通过 ComfyUI Partner Nodes 正式接入 ComfyUI 生态。这意味着你可以利用其独特的“推理式生成”能力,在本地或云端工作流中实现前所未有的控制力与准确性。
核心理念:先思考,后绘画
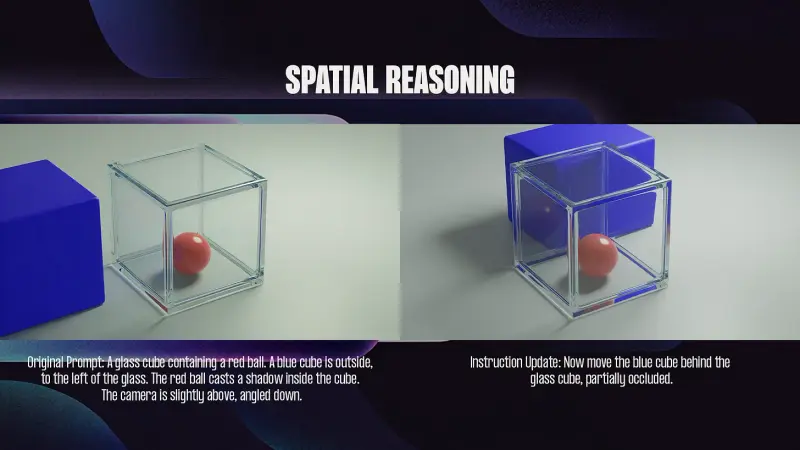
与传统扩散模型“一步到位”生成像素不同,Uni-1 的工作流程更接近人类艺术家或大型语言模型(LLM):
- 理解与分解:接收提示词后,模型首先进行内部推理,分解复杂指令,识别约束条件。
- 规划构图:在生成任何像素之前,模型已在潜在空间中规划好画面布局、逻辑关系和时间序列。
- 自回归生成:基于规划好的蓝图,逐个 Token 地生成图像序列,确保每一步都符合整体逻辑。
这种机制使得 Uni-1 在处理复杂指令、空间关系和逻辑约束时,表现出远超传统模型的鲁棒性。
核心功能亮点
1. 精准文本渲染与多语言支持
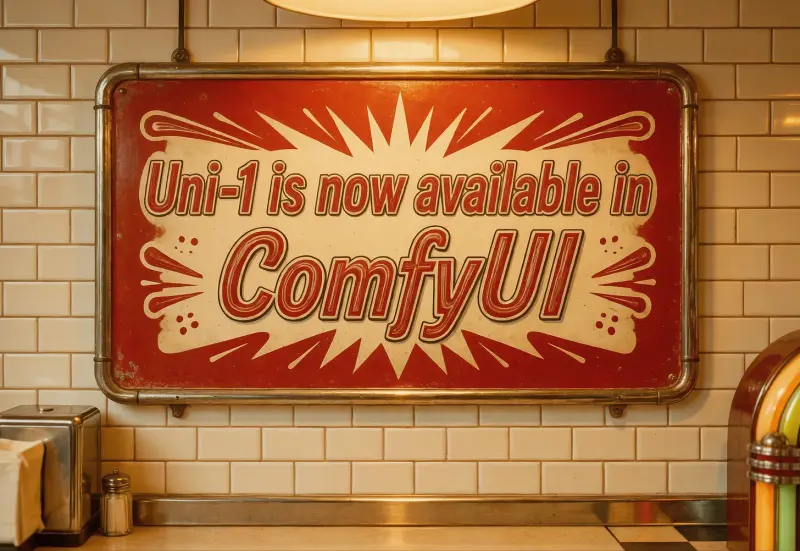
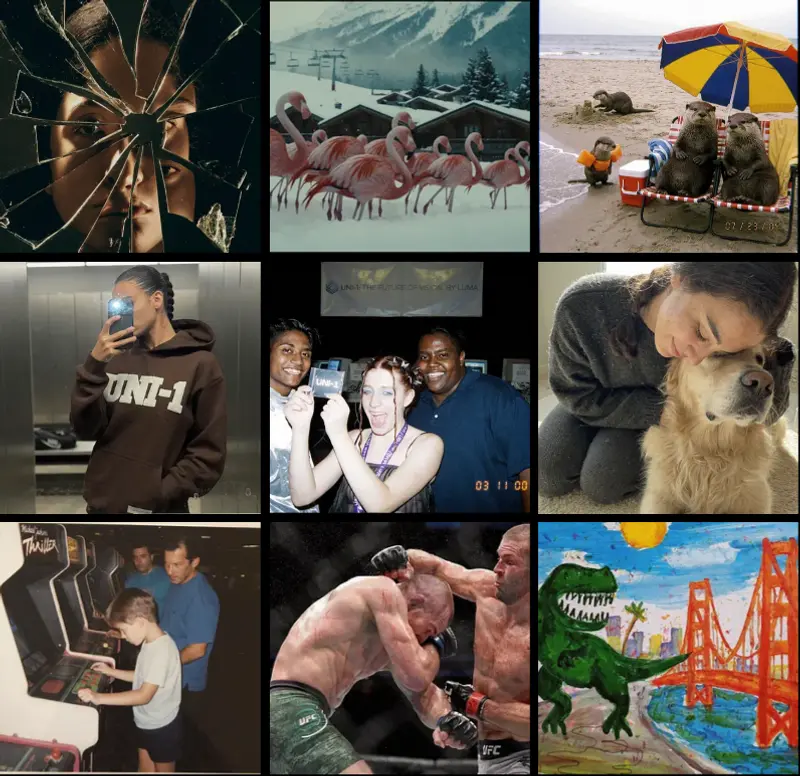
- 可读文本:彻底解决 AI 绘图“乱码”痛点,生成清晰、准确且符合语境的文字内容。
- 多语言提示:原生支持多种语言输入,无需依赖翻译中间件,理解更地道。
2. 统一生成与编辑
- 无缝编辑:支持多轮对话式修改。你可以上传源图像,通过自然语言指令调整细节、更换背景或修改主体,而无需重新生成整图。
- 身份保留:在参考引导生成中,能极好地保持人物或物体的身份特征(Identity Preservation),适合角色一致性创作。
3. 网络搜索接地 (Web Search Grounding)
- 实时信息整合:模型可结合网络搜索结果生成图像,确保内容反映最新事实、趋势或特定实体细节,减少幻觉。
4. 高级构图与输出
- 多面板输出:支持生成具有时间一致性的多面板漫画或故事板,保持角色和风格在不同分镜间的高度连贯。
- 照片级真实感:具备极高的材质准确性和光影表现力,输出效果逼真自然。
- 灵活宽高比:支持 9 种预设宽高比,适配从手机壁纸到电影宽银幕的各种场景。
如何在 ComfyUI 中使用 Uni-1?
前置准备
- ComfyUI 版本:确保已更新至最新版本,或直接使用 Comfy Cloud。
- 节点安装:通过 ComfyUI Manager 搜索并安装 Luma UNI-1 Image 节点(属于 Partner Nodes 系列)。
快速开始工作流
- 加载节点:
- 右键点击画布 ->
Add Node->Luma->UNI-1 Image。 - 或者从
Templates面板直接加载官方提供的 Uni-1 模板。
- 右键点击画布 ->
- 配置输入:
- Text-to-Image:在
prompt输入框中输入描述性提示词。 - Image-to-Image / Edit:连接源图像到
image输入端,并在提示词中描述修改意图(如:“把背景换成雪山”)。
- Text-to-Image:在
- 调整参数:
- 选择所需的 Aspect Ratio(宽高比)。
- (可选)启用 Web Search 以获取实时上下文。
- 运行生成:
- 点击
Queue Prompt,等待模型完成“思考”与“绘制”过程。
- 点击
© 版权声明
文章版权归作者所有,未经允许请勿转载。