就在几周前,谷歌推出的 Gemma 4 以其卓越的每参数智能赢得了全球开发者的青睐,下载量迅速突破 6000 万次。今天,谷歌再次推动效率边界,正式发布了 Gemma 4 系列的多 Token 预测 (Multi-Token Prediction, MTP) 草稿器。
- 官方介绍:https://blog.google/innovation-and-ai/technology/developers-tools/multi-token-prediction-gemma-4
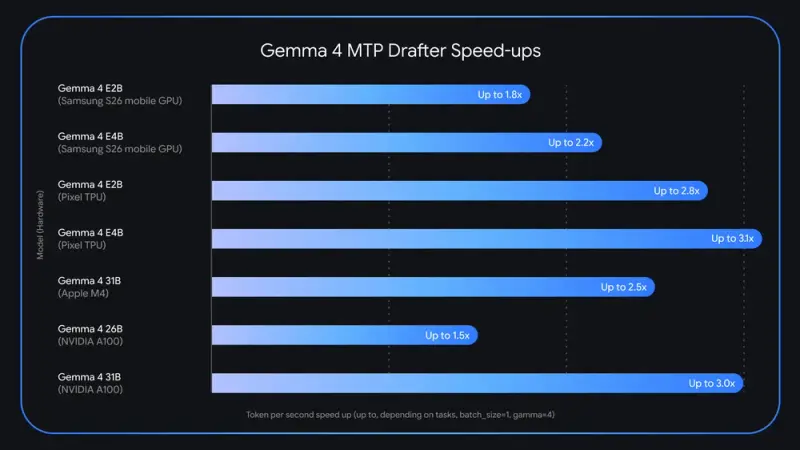
通过引入专门的推测解码架构,这些轻量级草稿器能够与 Gemma 4 主模型完美配合,在不降低任何输出质量或推理逻辑的前提下,将推理速度提升高达 3 倍。这对于需要在本地设备、边缘终端或云端进行低延迟部署的开发者而言,无疑是一剂强心针。
为什么需要推测解码?
大型语言模型 (LLM) 的推理速度长期受限于内存带宽瓶颈。在标准自回归生成中,处理器大部分时间都耗费在将数十亿参数从显存 (VRAM) 搬运到计算单元上,仅为了生成一个 Token。这种“计算少、搬运多”的模式导致了资源利用率低下和高延迟,尤其在消费级硬件上表现明显。
推测解码 (Speculative Decoding) 通过将 Token 生成与验证解耦来解决这一痛点:
- 草稿器 (Draft Model):一个轻量级模型利用空闲计算资源,快速“预测”多个未来的 Token。
- 目标模型 (Target Model):重型主模型并行验证这些提议的 Token。
- 批量接受:如果目标模型同意草稿,它会在一次前向传递中接受整个序列,并额外生成一个新 Token。
这意味着,应用程序可以在通常生成一个 Token 的时间内,输出完整的草稿序列外加一个确认 Token,从而实现显著的加速。
Gemma 4 MTP 的核心优势
1. 极速响应,打破延迟瓶颈
- 3 倍加速:在典型负载下,推理吞吐量提升显著,大幅降低聊天、语音应用和自主代理的等待时间。
- 零质量损失:由于最终验证由强大的 Gemma 4 主模型执行,输出的准确性、逻辑性和安全性与标准推理完全一致。
2. 解锁本地与边缘潜力
- 消费级 GPU 友好:让个人电脑也能流畅运行 Gemma 4 26B MoE 和 31B Dense 等大参数模型,支持复杂的离线编码和代理工作流。
- 移动端优化:在 Android/iOS 设备上,Gemma 4 E2B/E4B 边缘模型结合 MTP 后,生成速度更快,显著节省电池寿命,提升用户体验。
3. 🛠️ 架构级高效设计
- KV 缓存共享:草稿模型无缝复用目标模型的激活值和 KV 缓存,避免重复计算上下文,极大减少冗余开销。
- 高效嵌入器聚类:针对边缘模型,在嵌入层引入聚类技术,进一步加速 Logit 计算瓶颈。
- 批量处理增益:在 Apple Silicon 和 Nvidia A100 等硬件上,通过适当增加批量大小(如 4-8),可进一步挖掘并行加速潜力(局部加速可达 2.2 倍以上)。
广泛兼容,即刻上手
Gemma 4 MTP 草稿器遵循 Apache 2.0 开源协议,已全面集成到主流 AI 框架中:
- 支持框架:Hugging Face Transformers, MLX, vLLM, SGLang, Ollama。
- 获取方式:模型权重已在 Hugging Face 和 Kaggle 上线。
- 移动端体验:可直接在 Google AI Edge Gallery 中为 Android 或 iOS 应用试用。
如何开始使用?
- 下载模型:从 Hugging Face 获取 Gemma 4 主模型及对应的 MTP 草稿器权重。
- 配置环境:确保你的推理框架(如 vLLM 或 Ollama)已更新至支持推测解码的最新版本。
- 启用 MTP:在加载模型时指定草稿器路径,启动服务即可享受加速效果。
💡 提示:对于本地开发者,建议尝试不同的批量大小设置,以在特定硬件上找到速度与显存占用的最佳平衡点。
© 版权声明
文章版权归作者所有,未经允许请勿转载。