制作一个高质量的动漫角色 LoRA 通常意味着数小时的手动截图、裁剪、打标和整理。Neme-Anima是一个自动化工具,能够从视频中智能提取角色图像,自动标注,并针对 Anima 模型进行一键式 LoRA 训练。
- GitHub:https://github.com/negaga53/neme-anima
无论是从番剧、游戏 CG 还是自制视频中提取角色,Neme-Anima 都能帮你将繁琐的数据准备工作压缩为简单的“三步走”。
核心流程:三步构建 LoRA
1. 智能提取:从视频到角色裁剪图
- 镜头分割:使用
PySceneDetect将视频切分为独立镜头。 - 角色检测与追踪:利用
DeepGHS YOLO检测每帧中的角色,并通过ByteTrack链接成轨迹片段。 - 身份匹配 (CCIP):上传一张参考图,系统通过
CCIP算法自动识别并匹配视频中所有该角色的轨迹片段,排除无关人物。 - 精选帧提取:基于清晰度、可见性和宽高比,从每个轨迹中挑选最佳帧,并裁剪为适合 SDXL 级模型(最长边 1024px)的图像。
- 去重优化:再次运行 CCIP,在滑动窗口内删除近似重复的帧,确保数据集多样性。
2. 自动标注:WD14 + 自然语言描述
- 标签生成:使用
WD14 EVA02-Large v3为每张裁剪图生成标准的 Danbooru 风格标签。 - 自然语言描述:同时生成易于理解的自然语言描述,增强模型对语义的理解。
- UI 重组与编辑:在 Web UI 中直观查看、筛选、修改标签,支持正则表达式批量替换,轻松清洗数据集。
3. 一键训练:针对 Anima 优化
- 预置参数:内置针对 Anima 模型优化的训练参数,无需复杂调优。
- 队列训练:支持多角色排队训练,每个角色生成独立 LoRA。
- 高级控制:提供“核心标签修剪”和“重复乘数”等高级旋钮,精细控制训练效果。
- 兼容性强:提取器和标注器生成的数据集完全兼容
kohya-ss、OneTrainer和sd-scripts,可用于训练 SDXL、Pony、Illustrious 等其他模型。
技术亮点
- 高精度身份识别 (CCIP):相比传统面部识别,CCIP 能更好地处理动漫角色的多变造型和遮挡情况,确保提取到的都是“同一个角色”。
- 缓存机制:检测和追踪结果被缓存,调整阈值或重新运行时可跳过耗时步骤,大幅提升迭代效率。
- Web UI 交互:提供直观的图形界面,支持拖放管理图片、实时预览标签、按角色筛选等功能,降低操作门槛。
- 模块化设计:提取/标注模块与训练模块解耦,用户可只使用前半部分生成高质量数据集,再导入其他训练框架。
快速开始
一键安装与运行 (Linux / WSL2)
bash install_and_run.sh
该脚本将自动:
- 安装
uv和 Node.js。 - 同步 Python 依赖。
- 克隆并设置
diffusion-pipe训练后端。 - 下载约 14 GB 的 Anima 训练权重(可跳过)。
- 启动 Web UI 服务器。
CLI 模式示例
# 创建项目
uv run neme-anima project create ~/projects/megumin --name megumin

# 添加参考图和视频
uv run neme-anima project add-ref ~/projects/megumin ref.png
uv run neme-anima project add-video ~/projects/megumin ep01.mkv

# 执行提取
uv run neme-anima project extract ~/projects/megumin
系统要求
- 提取/标注:英伟达显卡,最低 4GB 显存(推荐 8GB+)。
- 训练:Linux / WSL2,CUDA 12.4+,NVIDIA GPU,最低 6GB 显存(全分辨率 LoRA 推荐 18GB+)。
Web UI 功能概览
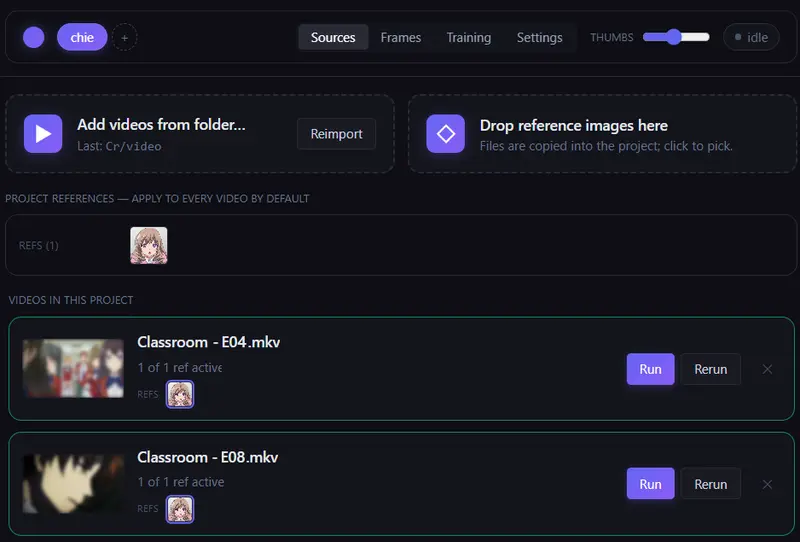
- 源 (Sources):管理视频文件和角色参考图。
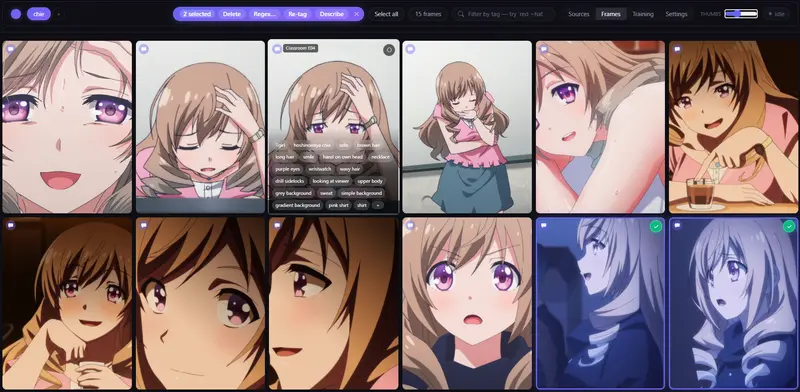
- 帧 (Frames):
- 可视化数据集浏览,悬停查看标签。
- 支持 Shift/Ctrl 多选,批量移动/删除图片。
- 点击标签药丸进行编辑,支持正则批量替换。
- 按角色筛选,重新裁剪图片。
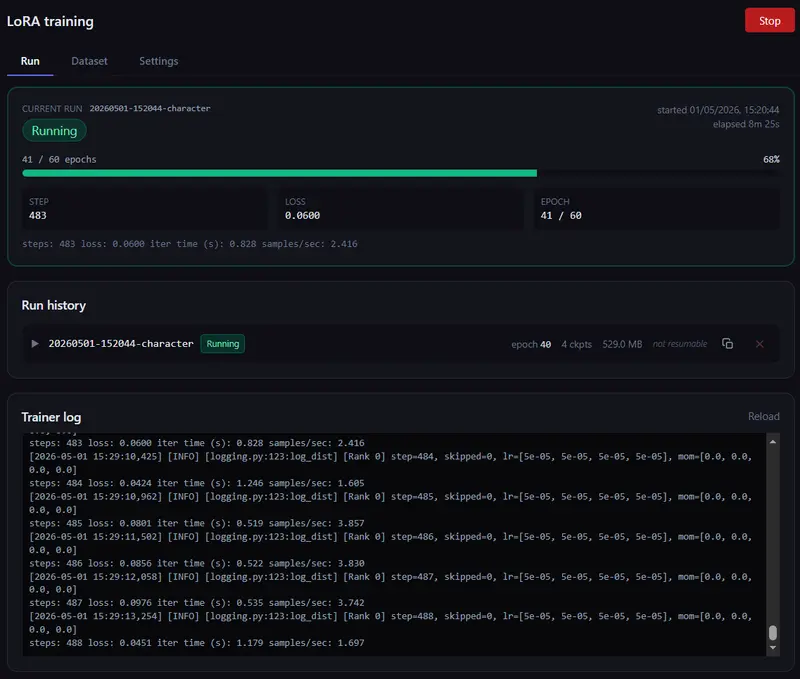
- 训练 (Training):
- 启动 LoRA 训练,支持暂停/恢复。
- 调整核心标签修剪和重复采样策略。
- 设置 (Settings):配置
diffusion-pipe路径及模型权重位置。
© 版权声明
文章版权归作者所有,未经允许请勿转载。