PandaWiki
PandaWiki 是一款 AI 大模型驱动的开源知识库搭建系统,帮助你快速构建智能化的 产品文档、技术文档、FAQ、博客系统,借助大模型的力量为你提供 AI 创作、AI 问答、AI 搜索 等能力。
shoehorn 是一款开源工具,解决本地运行大语言模型时的核心痛点:如何在不浪费显存也不导致 OOM(显存溢出)的前提下,最大化模型质量? 传统的预设量化(如 Q4_K_M)往往忽略硬件差异,导致要么留下数百 MB 的未利用空间,要么因估算不准而无法加载。shoehorn 通过求解一个复杂的每张量混合精度分配方案,将模型的每一兆字节都用...
 shoehorn
 是一款开源工具,解决本地运行大语言模型时的核心痛点:如何在不浪费显存也不导致 OOM(显存溢出)的前提下,最大化模型质量? 传统的预设量化(如 Q4_K_M)往往忽略硬件差异,导致要么留下数百 MB 的未利用空间,要么因估算不准而无法加载。shoehorn 通过求解一个复杂的每张量混合精度分配方案,将模型的每一兆字节都用在刀刃上,实现 99.9% 以上的显存利用率。
llama-server 启动功能,一键提供服务。brew install notactuallytreyanastasio/shoehorn/shoehorn
llama.cpp,然后通过 cargo install 安装 shoehorn。# 自动下载 BF16 模型,生成 imatrix,求解混合方案,量化并启动服务
shoehorn fit unsloth/Qwen3-4B-GGUF --serve
# 1. 探测显存
shoehorn vram

# 2. 针对特定预算量化(例如 1.75 GiB)
shoehorn quantize -m Qwen3-0.6B-BF16.gguf -i qwen3.imatrix \
    --ctx 4096 --budget 1.75GiB -o fitted.gguf

# 3. 运行
shoehorn run -m fitted.gguf --ctx 4096
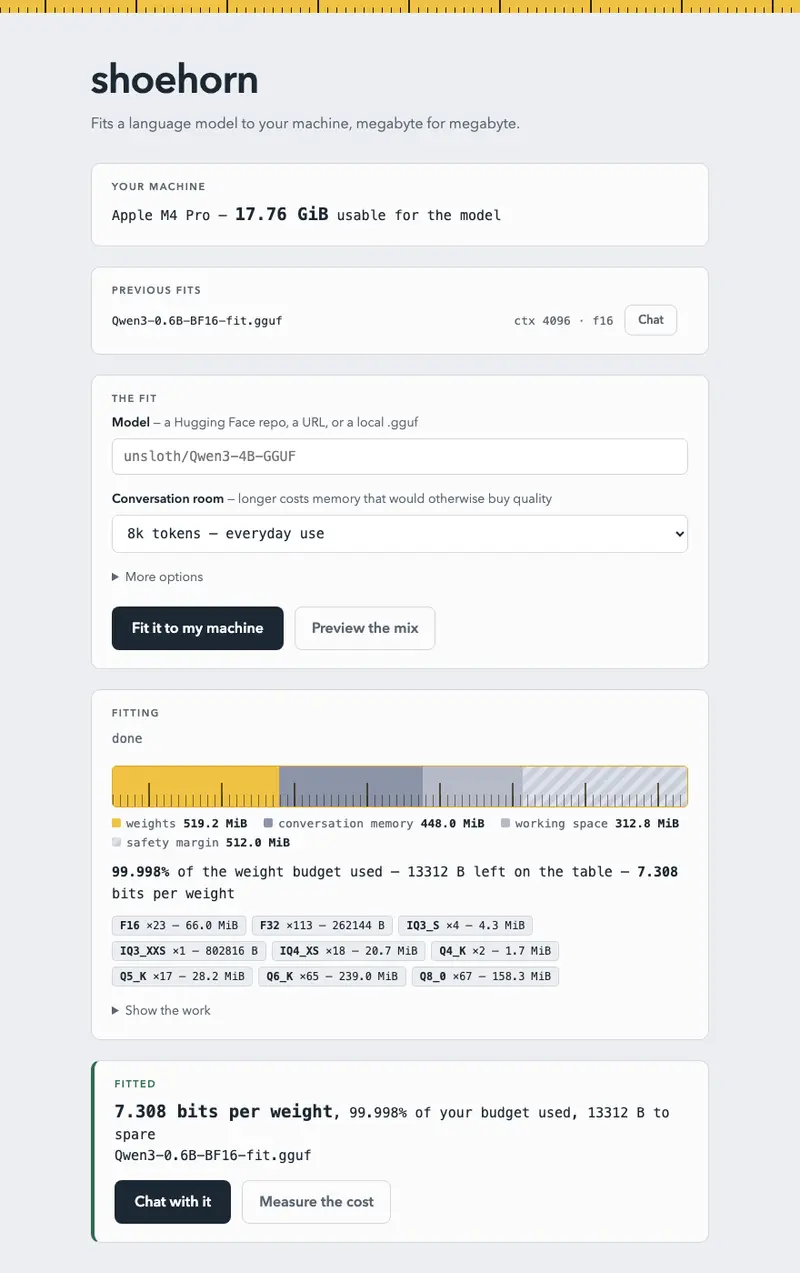
shoehorn 提供了一个直观的 Web 界面 (shoehorn ui),让你无需记忆命令行参数即可操作:
| 模型 | 硬件 | 预算 | shoehorn 表现 | 对比基线 |
|---|---|---|---|---|
| Qwen3-0.6B | M4 Pro (24GB) | 1.75 GiB | 7.306 bpw, PPL +0.6% | 比 llama.cpp IQ2_XXS PPL 低一半 |
| Qwen3-14B | M4 Pro (24GB) | 8 GiB | 3.42 bpw, PPL 6.85 | 在 8GB 显存上流畅生成,质量远超同尺寸小模型 |
| Qwen3-30B-A3B | M4 Pro (24GB) | 17.76 GiB | 4.75 bpw, PPL 6.91 | 50.6 tok/s,交互速度运行 30B MoE 模型 |