BarraCUDA
BarraCUDA是一个面向 AMD GPU 的开源 CUDA 编译器,并计划支持更多架构。用 15000 行 C99 代码编写。零 LLVM 依赖。直接将 .cu 文件编译为 GFX11 机器码,并生成 AMD GPU 可以实际运行的 ELF .hsaco 二进制文件。
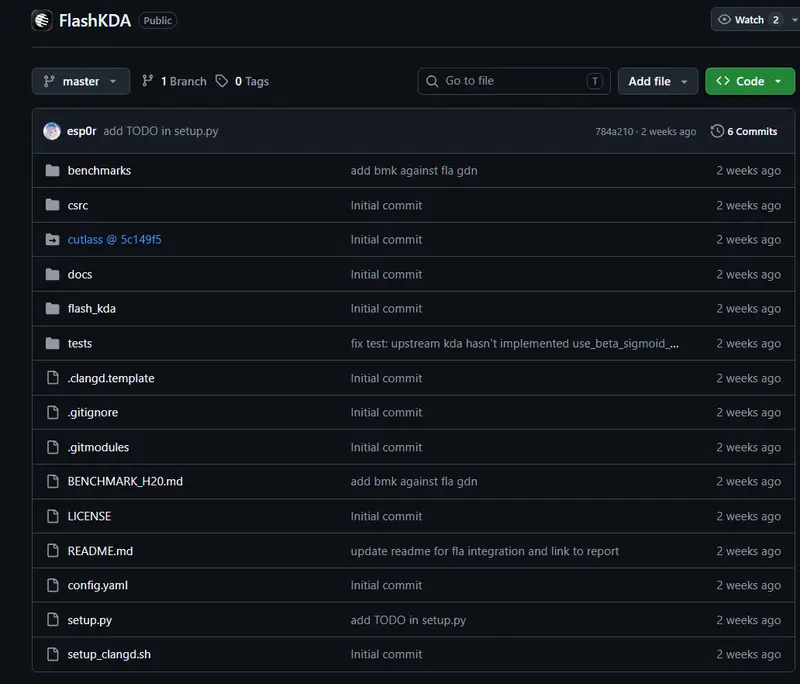
月之暗面开源的FlashKDA是一个基于 NVIDIA CUTLASS 库构建的高性能 CUDA 内核,专为 Kimi Delta Attention (KDA) 机制打造。
 FlashKDA
在长上下文大模型推理中,注意力机制的效率直接决定了系统的吞吐量与成本。月之暗面(Moonshot AI)正式开源 FlashKDA,这是一个基于 NVIDIA CUTLASS 库构建的高性能 CUDA 内核,专为 Kimi Delta Attention (KDA) 机制打造。
作为 Kimi Linear 模型的核心组件,FlashKDA 在 NVIDIA H20 GPU 上实现了比现有 flash-linear-attention 基线高出 1.72 倍至 2.22 倍 的预填充加速,并支持关键的生产级特性——可变长度批处理。
flash-linear-attention 库中的 chunk_kda 操作。flash-linear-attention 的代码库无需任何改动即可享受性能红利,极大降低了迁移成本。flash-linear-attention 进行交叉验证,确保数值精度完全匹配。cu_seqlens 参数处理不同长度的序列批次。FlashKDA 是 Kimi Delta Attention 的物理实现。KDA 是 Moonshot AI 对线性注意力机制的重要创新:
K = V = 128git clone https://github.com/MoonshotAI/FlashKDA.git
cd FlashKDA
pip install -e .
安装完成后,无需修改代码,只需确保你的模型使用的是 flash-linear-attention 中的 KDA 实现,FlashKDA 将自动介入加速。
import flash_kda

# 核心 API: flash_kda.fwd
# 支持 q, k, v, g, beta, scale, out, 门参数, 循环状态及 cu_seqlens
output = flash_kda.fwd(
    q=q, k=k, v=v, g=g,
    beta=beta, scale=scale,
    out=out,
    # ... 其他参数
    cu_seqlens=cu_seqlens  # 启用可变长度批处理
)
| 特性 | 描述 |
|---|---|
| 性能提升 | H20 GPU 上预填充加速 1.72x – 2.22x |
| 集成方式 | 即插即用,自动替换 flash-linear-attention 后端 |
| 核心架构 | 基于 CUTLASS,针对 SM90+ (Hopper) 优化 |
| 关键功能 | 支持 可变长度批处理 (cu_seqlens),适配生产环境 |
| 应用场景 | Kimi Linear 模型,长上下文高效推理,KV 缓存大幅缩减 |
| 开源协议 | MIT License |