OpenChatBI
OpenChatBI 是一款开源的、基于聊天的智能 BI 工具,由大语言模型驱动,旨在帮助用户通过自然语言对话查询、分析和可视化数据。它基于 LangGraph 和 LangChain 生态构建,提供支持自然语言转 SQL 以及流畅数据分析的聊天代理和工作流。
llama.cpp 是知名开源本地大模型推理项目,底层基于 ggml 库,目标是用最简配置,在PC、边缘设备上高效跑LLM与VLM多模态模型,同时也支持云端部署。项目采用纯C/C++编写,无外部依赖,对全平台硬件做深度适配。
 llama.cpp
 是知名开源本地大模型推理项目,底层基于 ggml 库,目标是用最简配置,在PC、边缘设备上高效跑LLM与VLM多模态模型,同时也支持云端部署。项目采用纯C/C++编写,无外部依赖,对全平台硬件做深度适配。
支持1.5bit、2bit、3bit、4bit、5bit、6bit、8bit多种整型量化,大幅降低显存占用,提升推理速度,GGUF格式现已成为本地模型主流格式。
提供多种部署途径:一键脚本安装、Docker容器、直接下载预编译二进制包、源码编译。
安装完成后,两条核心命令:
# 从Hugging Face直接拉取并运行GGUF模型
llama cli -hf ggml-org/Qwen3.5-0.8B-GGUF
# 启动OpenAI兼容API服务,可供其他应用接入
llama serve -hf ggml-org/Qwen3.5-0.8B-GGUF
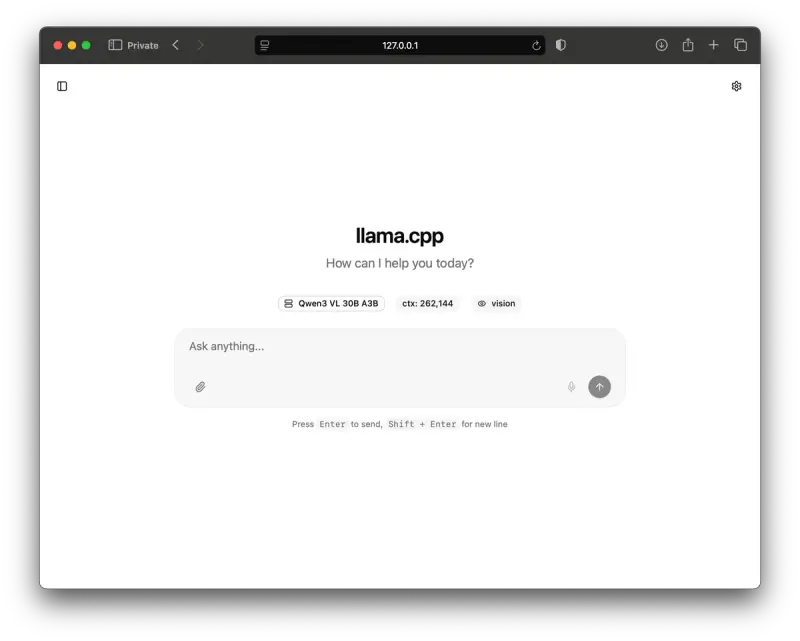
ggml-org同步推出桌面端托盘应用 Llama,分为 Windows 版与 macOS 版,封装 llama.cpp,降低普通用户上手门槛。
Alt+Space全局唤起对话浮窗,无需切换窗口brew install --cask llama-app 或手动安装包部署[http://localhost:9931/v1](http://localhost:9931/v1),兼容OpenAI接口,可供编辑器、Agent调用