llm.pdf
llm.pdf 不是为了替代现有的 LLM 部署方式,而是对“计算载体边界”的一次有趣探索。它证明了 PDF 这种看似静态的文档格式,也能成为完整 AI 推理的容器。
 TorchTPU
谷歌与 Meta 的 PyTorch 团队近日联合宣布,正式开源 TorchTPU。这是一个专为 Google Cloud TPU 设计的原生 PyTorch 后端,于 2026 年 10 月 20 日的 PyTorch Conference 上正式发布。谷歌官方明确表示,TorchTPU 将取代原有的 PyTorch/XLA,并推荐所有新的工作负载迁移至该平台。
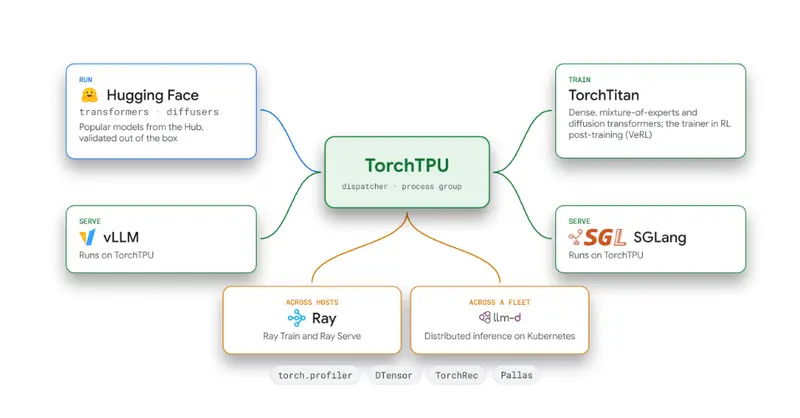
TorchTPU 通过 PyTorch 的 PrivateUse1 接口无缝插入,允许开发者直接使用标准的 torch.device("tpu") 调用 TPU。与 PyTorch/XLA 依赖惰性张量图(Lazy Tensor Graph)和纯 SPMD(单程序多数据)执行不同,TorchTPU 采用 Eager(即时)优先的执行模型,原生支持发散的 MPMD(多程序多数据)执行,且张量为标准 PyTorch 张量,无需子类或包装器。
其执行路径分为两种模式:
torch.compile(backend="tpu") 调用 TorchDynamo 捕获计算图,经由 StableHLO 降级至 OpenXLA,最终生成 TPU 机器代码。编译后的可执行文件可在进程、主机和作业重启间缓存。根据谷歌及其合作伙伴的自报数据,TorchTPU 在训练和扩展性上表现优异:
torch.compile),单步训练时间从 11.49 秒大幅降至 2.78 秒(提升约 3.80 倍)。TorchTPU 提供了丰富的生态集成,确保主流 AI 框架和模型能够平滑迁移:
device_map="tpu" 直接部署;Diffusers 支持 Eager、torch.compile 及张量并行。vLLM-TorchTPU,联合 RadixArk 推出 SGLang-TorchTPU,保留了原有的调度器与前缀重用机制,并支持 FP8 KV 缓存、FP8/MXFP4/NVFP4 检查点,以及 MTP 和 EAGLE-3 推测解码。tpu_dist 进程组原生支持 DDP、FSDP2 和 DTensor,并提供针对 TPU 互连拓扑感知的网格配置。