CUA-Lite
加州大学伯克利分校研究团队推出 CUA‑Lite,面向计算机使用代理(CUA)的开源研究平台。项目跳出 “以模型为中心” 的思路,聚焦基础设施层面的痛点:训练、评测计算机使用代理,需要代理、运行环境、交互轨迹、训练评估框架四大组件,但现有资源分散在互不兼容的独立仓库。CUA‑Lite 将它们整合,提供统一操作空间、统一数据格式与统一调用接口,覆盖桌面、浏览器、移动端三大场景。
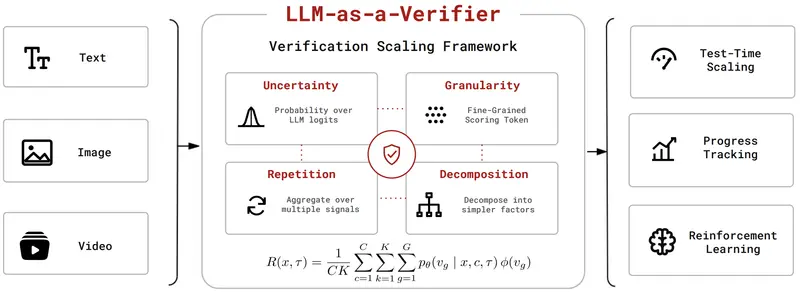
LLM-as-a-Verifier 是一个通用框架,无需额外训练即可为任何代理提供细粒度反馈。通过利用评分 token logits 的完整分布,我们的方法捕获评估不确定性,并使验证沿着三个维度扩展:评分粒度、重复评估和标准分解。
 LLM-as-a-Verifier
 是一个创新的通用评估框架,为大语言模型(LLM)驱动的智能体(Agents)提供无需额外训练即可使用的细粒度反馈。该框架通过深度挖掘评分 Token logits 的完整分布,不仅捕获了评估过程中的不确定性,还实现了在评分粒度、重复评估和标准分解三个维度上的扩展。其生成的连续奖励信号可直接用于测试时扩展(Test-time Scaling)、实时进度跟踪以及强化学习(RL)训练。
llm_verifier.select、compare 和 track 等核心接口,开发者仅需几行代码即可实现最佳-of-N 选择、成对评分及轨迹进度跟踪,极大地降低了集成门槛。