FlowGram.AI
FlowGram 是一套基于节点编辑的流程搭建引擎,帮助开发者快速创建固定布局或自由连线布局模式的流程,并提供一套交互的最佳实践, 很适合有明确输入和输出的可视化工作流。
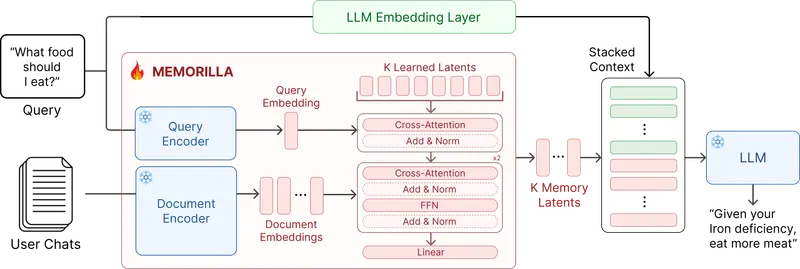
斯坦福 SNAP 小组推出开源记忆系统 Memorilla,专门适配冻结状态的 LLM。它可以读取整套文档集,只向冻结大模型送入固定 16 个记忆 token,在降低 token 开销的同时,多数场景下检索问答效果优于直接把全部文档塞进上下文。
 Memorilla
斯坦福大学 SNAP 实验室联合多伦多大学、宾夕法尼亚大学及 MIT 的研究人员正式开源了 Memorilla,一种专为冻结大语言模型(LLM)设计的轻量级记忆系统。该系统通过一个仅 1.94 亿参数的可训练模块,将庞大的文档集合压缩为固定的 16 个记忆 Token,直接注入到冻结的 LLM 输入端。实验显示,在 FactKG 基准测试中,Memorilla 不仅比完整上下文提示高出近 4 个百分点的准确率,还将所需的文档 Token 数量减少了 108 倍,显著提升了推理效率与长文本处理能力。
传统长文本处理通常面临两难:要么使用完整上下文导致速度极慢且超出窗口限制,要么使用检索增强生成(RAG)可能遗漏弱相关线索。Memorilla 提出了第三种方案:学习式压缩。
其工作流程分为三个关键步骤:
在此架构中,编码器(Qwen3-Embedding-4B)和解码器(Qwen3-8B)均保持冻结状态,仅有这 1.94 亿参数的记忆模块参与训练。
在 8 个主流基准测试中,Memorilla 取得了平均 49.68 的最高分,在 5 个单项中位列第一。
| 基准测试 | Memorilla (Qwen3-8B) | 完整上下文 (Full Context) | MemoRAG | LLMLingua-2 | 备注 |
|---|---|---|---|---|---|
| FactKG | 84.33% | 80.43% | 80.38% | – | Token 减少 108 倍 |
| PersonaMem-v2 | 44.60% | 27.92% | – | – | 显著优于次优方法 xRAG (30.90%) |
| TriviaQA | 57.00% | – | 56.60% | – | 精确匹配率略胜 |
| LaMP-4 / LaMP-7 | 18.15 / 48.37 | – | – | – | ROUGE-L 最佳分数 |
| PubMedQA | 59.00% | – | – | 69.00% | 短文本场景下压缩优势不明显 |
注:在 NarrativeQA 任务中,Memorilla 实现了惊人的 4,212 倍 Token 压缩率(16 个 Token 替换 67,385 个文档 Token)。
在处理大规模文档时,Memorilla 的速度优势极为显著。在单块 H100 GPU 上处理 512 个文档(约 128K Token):
此外,通过引入记忆缓存预计算交叉注意力的键值对,在 B200 GPU 上处理 100 万个文档的查询仅需 8.1 毫秒(经 torch.compile 优化后可降至 5.0 毫秒),尽管这会占用约 80 GiB 的显存。
Memorilla 的训练分为三个阶段,总计在 4 块 H100 GPU 上耗时约 19 小时:
部署指南:
uv 进行环境管理。MemoryVLLM.from_pretrained 加载检查点。首次运行需下载约 25 GB 模型文件。collection_id, question, answer, documents 列的 Parquet 文件。尽管表现优异,Memorilla 在部分细粒度事实问答(如 PubMedQA)上仍落后于专门的压缩工具 LLMLingua-2,这主要因为在短文本场景下,压缩带来的信息损失可能超过其效率增益。此外,目前尚未公布量化变体,对显存有一定要求(快速开始推荐 80 GB GPU)。
Memorilla 的开源为构建高效、低成本的长文本 AI 应用提供了新的思路,特别是在需要频繁访问庞大知识库且对延迟敏感的场景中,其“固定 Token 输出”的特性极具吸引力。