Skill Seeker
Skill Seeker 是一款自动化工具,可在 20–40 分钟内 将技术文档网站、GitHub 仓库或 PDF 文件转换为 生产就绪的 Claude AI 技能(Skill),大幅减少手动整理、总结和结构化文档的时间成本。
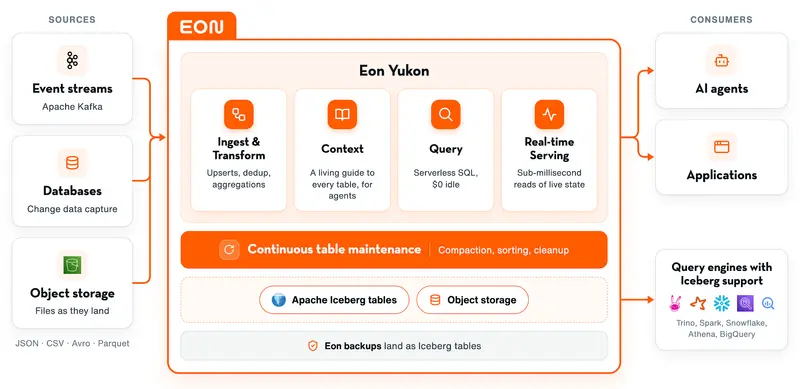
Eon.io 正式推出 Eon Yukon,一款面向 AI 智能体、业务应用与数据分析的高性能实时数据层,把数据摄取、转换、聚合、表维护、实时查询服务整合在一套无服务器引擎里,核心目标是降低实时数据链路的运维复杂度,并且在数据抵达的同时,为智能体提前构建好数据上下文。
 Eon Yukon
Eon.io 正式推出 Eon Yukon,这是一款面向智能体(Agents)、应用程序和数据分析的高性能数据层。该产品旨在解决传统数据架构中因拼接多个独立系统(如摄取、转换、聚合、表维护和服务)而导致的计算冗余、管理复杂以及数据新鲜度延迟等问题。
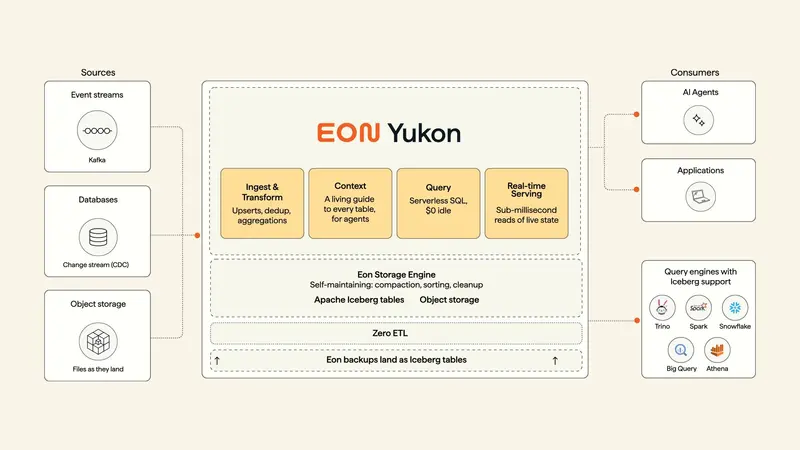
Eon Yukon 将数据的摄取、处理、表维护和实时服务整合至单一流程中,其底层架构设计主要围绕以下三个工程维度展开:
为了量化保持开放格式表可用性的真实成本,Eon 开发了 ingest-bench 基准测试工具,综合评估数据新鲜度、文件大小以及计算资源消耗。在每秒处理 100 万事件(吞吐量超过 1.4 GiB/s)、从 Kafka 写入 Iceberg 的持续一小时测试中,Eon Yukon 展现出显著的资源效率优势:
在数据存储与生态集成方面,Eon Yukon 坚持开放标准。它通过客户提供的访问角色,直接将数据以开放的 Apache Iceberg 表格式写入用户自有的 Amazon S3 或 Google Cloud Storage 中。这意味着数据始终保留在用户的云环境内,企业可以继续使用其现有的 Iceberg 查询引擎和数据目录,而不会将数据访问权限绑定于单一供应商。
目前,Eon Yukon 支持独立部署,也可与 Eon Data Protection 结合使用,后者通过 Zero-ETL 技术将受保护的数据同样以开放 Iceberg 表的形式提供,从而为分析、应用和 AI 构建统一的实时数据基础。