在 AI 代理(Agent)日益深入数据分析领域的今天,如何确保它们理解正确的业务语义、写出准确的 SQL 并遵循公司规范?ktx 是一个开源的数据智能体上下文层,它通过将数据仓库元数据、BI 工具定义、查询历史及文档转化为可审查、可执行的 Git 文件,为 Claude Code、Codex 等 AI 代理提供了一个共享且精准的知识工作空间。

核心亮点:上下文即代码,精准可控
1. 上下文即代码 (Context as Code)
- Git 版本控制:ktx 将 Wiki 页面、语义层定义(指标、维度、连接)存储为基于 Git的文件。
- 可审查工作流:支持对上下文变更进行 Diff 对比、Code Review 和合并,确保业务逻辑的演变透明且可控。
- 标准化输出:避免 AI 从头构建规范性 SQL,直接使用已批准的度量标准和筛选条件。
2. 自我改进的数据摄取
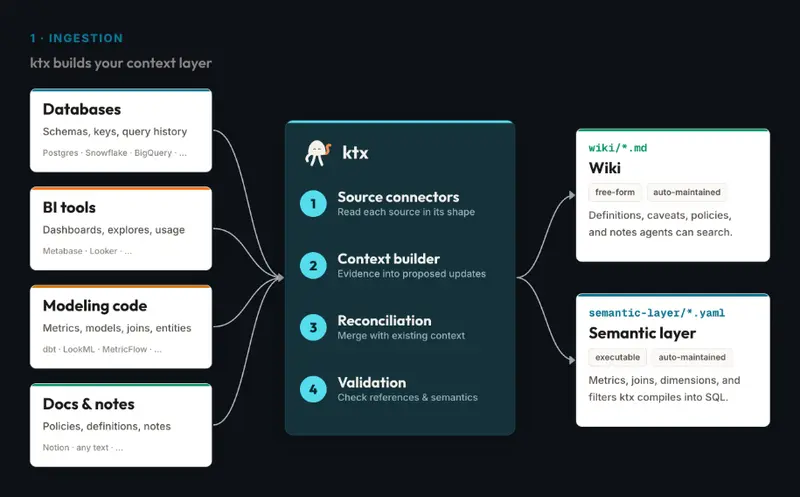
- 多源整合:自动读取数据仓库 schema、BI 工具配置、dbt/SQLModel 代码、历史查询日志及团队笔记。
- 智能调和:将新发现的证据与已接受的上下文进行比对和调和,自动更新
semantic-layer/ 和 wiki/ 目录,保持知识库的鲜活度。
3. 智能体原生访问 (MCP & CLI)
- MCP 集成:通过 Model Context Protocol (MCP) 暴露工具,让 AI 代理能直接搜索上下文、编译语义查询。
- 安全执行:支持运行只读 SQL,确保数据安全;同时允许 Agent 提出上下文更新建议,经人工审核后入库。
- 技能增强:赋予 Agent “记忆”能力,使其在回答复杂业务问题时能引用历史背景和公司规范。
工作原理:构建与服务双轮驱动
ktx 的工作流分为两个紧密连接的阶段:
| 阶段 | 功能描述 | 核心价值 |
|---|
| 1. 摄取与维护 | 扫描数据栈与公司知识库,提取元数据与业务逻辑,生成版本控制的差异文件。 | 自动化知识沉淀,减少人工维护成本,确保语义一致性。 |
| 2. 运行时服务 | 接收 Agent 请求,检索相关 Wiki 与语义实体,编译并执行语义查询。 | 精准问答与执行,消除 AI 幻觉,提升查询准确率与效率。 |
为什么需要 ktx?
- ❌ 传统痛点:
- AI 代理缺乏业务上下文,容易写出语法正确但逻辑错误的 SQL。
- 指标定义分散在 BI 工具、代码库和文档中,难以统一。
- 无法追溯 AI 查询背后的业务逻辑依据。
- ✅ ktx 解决方案:
- 统一语义层:将分散的定义集中管理,作为 Agent 的唯一真理来源。
- 可解释性:每次查询都基于明确的、可审查的上下文文件。
- 持续进化:随着使用增多,知识库自动丰富,Agent 越来越“懂”你的数据。
适用场景
- 自然语言查数 (NL2SQL):让业务人员通过对话获取准确数据,AI 基于 ktx 上下文生成合规 SQL。
- 自动化报表生成:Agent 根据 ktx 中的指标定义,自动编写 dbt 模型或 BI 仪表板配置。
- 数据血缘与影响分析:通过 Git 历史追踪指标定义的变更及其对下游查询的影响。
- 新员工入职培训:新分析师可通过 Agent 快速了解公司数据架构与业务术语,无需翻阅大量文档。
 ktx