Agensh
微软研究院开源 **Agensh**,面向大规模编码代理集群的去中心化运行框架(harness),最大亮点是**去掉传统方案里的中央编排 / 主代理**,不再由一个领导代理拆分任务、派活、合并结果。所有 Worker 代理自主认领子任务、互相协商冲突、把成果合并进共享 Git 仓库。
Google Cloud 正式开源 TPU Sync,这是一个专为 Cloud TPU 设计的 C++ 库,旨在解决大规模混合专家(MoE)模型推理中的关键瓶颈——模型状态移动。通过将 TPU HBM、主机 DRAM、共享存储及数据中心网络整合为统一的内存层级,TPU Sync 利用异步直接内存访问(DMA)技术,实现了 KV 缓存和模型...
 TPU Sync
Google Cloud 正式开源 TPU Sync,这是一个专为 Cloud TPU 设计的 C++ 库,旨在解决大规模混合专家(MoE)模型推理中的关键瓶颈——模型状态移动。通过将 TPU HBM、主机 DRAM、共享存储及数据中心网络整合为统一的内存层级,TPU Sync 利用异步直接内存访问(DMA)技术,实现了 KV 缓存和模型权重的高效传输。据 Google 内部测试显示,该库可将 Qwen3-235B 模型的 KV 传输延迟从数秒降至约 230 毫秒,降幅超过 90%。
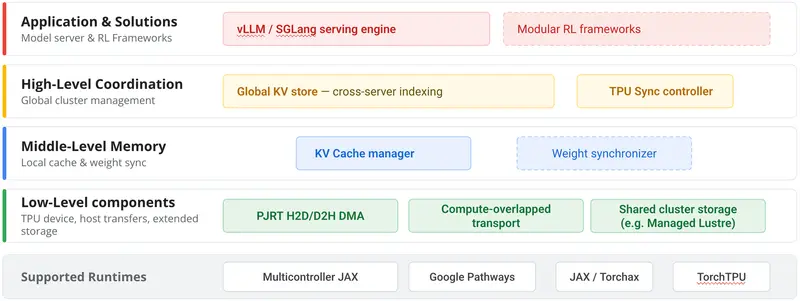
TPU Sync 的核心目标是消除数据移动带来的开销,而非单纯提升计算速度。其设计遵循以下四大原则:
TPU Sync 主要服务于两个关键场景:
此外,该库还包含一个全局 KV 存储用于前缀查找、一个传输控制器以及一个 KV 缓存管理器,共同构成了完整的状态管理解决方案。
Google 在 TPU v7x (Ironwood) 集群上进行了内部测试,技术栈包括 tpu-inference v0.24.0、JAX 0.10.2 和 libtpu 0.0.42.1。测试对象涵盖 235B 至 480B 参数的 MoE 模型。
| 指标 | 优化前 | 优化后 (TPU Sync) | 提升幅度 |
|---|---|---|---|
| Qwen3-235B KV 传输延迟 | 数秒 | ~230 毫秒 | > 90% |
| 低并发下平均 TTFT (235B) | – | – | 下降 60% |
| 低并发下平均 TTFT (480B) | – | – | 下降 90% |
| 高峰流量 Token 吞吐量 (235B) | – | – | 上升 30% – 70% |
| 64K 上下文前缀缓存 TTFT | – | – | 下降高达 90% |
| 前缀缓存有效容量 | – | – | 增长一个数量级 |
注:在 64K 上下文工作负载中,P99 令牌间延迟下降了 30%,整体吞吐量上升超过 50%。
尽管性能表现优异,Google 在 README 中明确指出 TPU Sync 目前尚不推荐用于一般生产用途,主要原因包括:
TPU Sync 的开源为大模型推理基础设施提供了新的优化思路,特别是在处理超长上下文和超大规模 MoE 模型时,其高效的 KV 缓存管理能力有望成为降低推理成本、提升响应速度的关键技术组件。