WorkflowAI
WorkflowAI是一个开源平台,供产品和工程团队合作构建和迭代AI功能,可以并行测试和比较80多种领先的人工智能模型,并评估其质量、成本和速度。
Google Research 联合东京大学、RIKEN AIP 和东北大学推出了 ToolGrad,这是一种革命性的工具使用数据生成框架。通过反转传统的“查询优先”流程,ToolGrad 实现了 99.8% 的数据通过率,并仅用 500 个样本就将 Gemma-3-12B 模型的性能提升至与 Gemini 2.5 Pro 相当的水平。
 ToolGrad
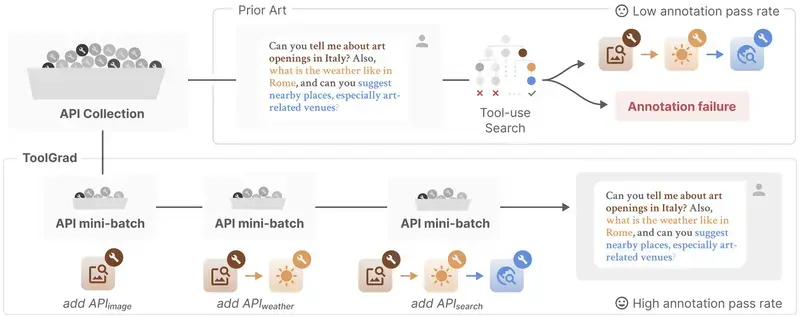
想要训练大模型稳定调用工具,需要大量「用户查询 + 对应工具调用链路」的配对数据集。但传统方式大规模生产这类数据,速度慢、成本高昂。来自 Google、东京大学、RIKEN AIP 与东北大学的联合团队推出 ToolGrad,改变了过往的数据构建思路:先搭建经过验证可正常执行的工具调用链,再反向生成匹配这条链路的用户查询。只用 500 条 ToolGrad 样本微调后的 Gemma-3 模型,在伯克利函数调用排行榜(BFCL)上,性能可以对标前沿闭源大模型。
项目可直接部署,代码采用 Apache-2.0 许可证,ToolGrad-500 数据集、1B/4B/12B 版本模型已上传至 Hugging Face,同时提供 PyPI 软件包。
传统的数据生成管道(如 ToolBench)通常遵循“查询优先”模式:先让 LLM 编造一个问题,再尝试寻找解决路径。这种方式效率低下,因为大量的搜索会走进死胡同,导致计算资源浪费且样本丢弃率高。
ToolGrad 彻底反转了这一逻辑:
优势:由于链条是真实可行的,从链到查询的转换只需一次 LLM 调用,极大地提高了生成的确定性和效率。
ToolGrad 通过四个模块的迭代循环来生成高质量样本:
默认配置下,每个工作流进行 10 次迭代,最终产出一个包含“用户查询 + 验证过的 API 链 + 最终响应”的高质量样本。
| 指标 | ToolBench (DFS) | ToolGrad | 提升/变化 |
|---|---|---|---|
| 通过率 | 63.8% | 99.8% | 🔺 显著跃升 |
| 真实工具使用数 | 2.1 | 3.4 | 🔺 链条更长 |
| 工具步骤数 | 34.3 | 20.0 | 🔻 更精简高效 |
| LLM 调用次数 | 64.5 | 63.9 | 🔻 略有下降 |
研究人员使用 ToolGrad 生成的 500 个样本对 Gemma-3 系列模型进行了后训练,结果令人瞩目: