Webwright

5个月前发布 201 00

微软研究院 AI Frontiers 实验室最新开源的 Webwright 框架赋予代理一个终端环境,让 AI 通过编写和执行 Playwright 代码来控制浏览器,从而实现了更稳定、更高效且可复用的 Web 交互。
所在地:
美国
收录时间:
2026-05-29
WebwrightWebwright

在 Web 自动化领域,传统的 AI 代理通常采用“观察-行动”循环,即模型接收页面截图或 DOM 后预测单次点击或输入。这种模式在处理复杂长程任务时往往显得僵化且易出错。微软研究院 AI Frontiers 实验室最新开源的 Webwright 框架赋予代理一个终端环境,让 AI 通过编写和执行 Playwright 代码来控制浏览器,从而实现了更稳定、更高效且可复用的 Web 交互。
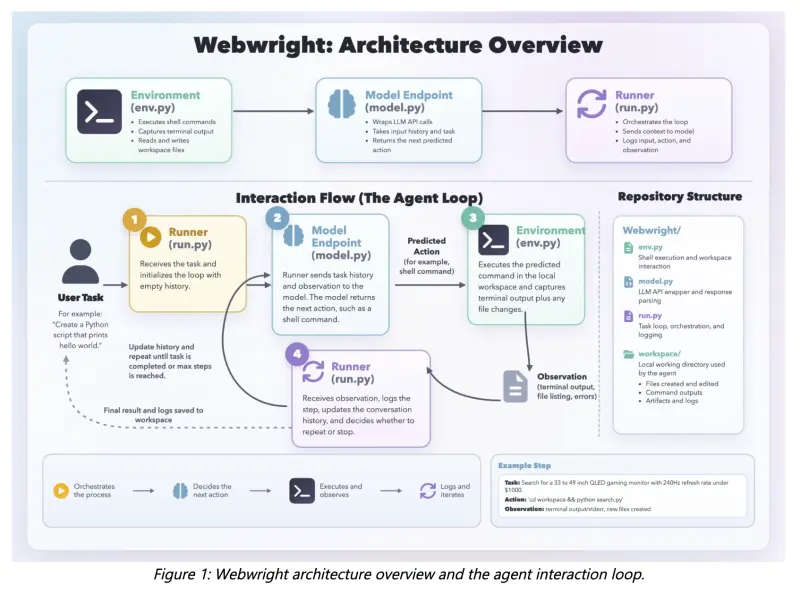
Webwright

核心创新:从“动作预测”到“代码生成”

1. 终端原生架构

  • 代码驱动:代理不再预测 x,y 坐标,而是编写 Python/JavaScript 代码(基于 Playwright 库)来操作浏览器。
  • 持久化工件:浏览器会话被视为临时资源,真正的持久化产物是本地工作区中的代码脚本、日志和截图。
  • 类开发者体验:模拟人类开发者编写 RPA 脚本的过程——编写、运行、调试、迭代,而非盲目点击。

2. 简洁高效的代理循环

Webwright 仅由三个核心组件构成(总代码约 1,000 行):

  • Runner:发送上下文给模型,接收思考块与 Shell 命令。
  • Model Endpoint:提供 LLM 推理能力。
  • Environment:执行命令,返回终端输出、日志、截图或错误回溯。

注:无复杂的多代理编排,单一代理循环即可处理复杂逻辑。

解决两大工程挑战

1. 防止过早“完成”

  • 自省门控机制:代理必须生成自省配置,在独立环境中运行最终脚本并自我评估成功与否,才能标记 done: true。否则,标志被丢弃并重试,确保任务真正完成。

2. 应对上下文爆炸

  • 历史压缩策略:每 20 步将历史轨迹压缩为摘要,有效管理长程任务的上下文长度,避免超出模型限制。

性能表现:显著超越基线

Webwright 在两个主流基准测试中展现了卓越性能:

基准测试Webwright (GPT-5.4)GPT-5.4 基线 (坐标预测)提升幅度
Odysseys (长程任务)60.1%33.5%+26.6 百分点 (相对提升 79.4%) 🚀
Online-Mind2Web (综合任务)86.67%–开源 Harness 方法中最高分
  • Odysseys 突破:相比此前 SOTA(Opus 4.6 的 44.5%),Webwright 提升了 15.6 个百分点;相比同模型基线,提升了 79.4%。
  • Online-Mind2Web 领先:在所有难度类别中均优于传统基于截图的代理方法。

成本与小模型潜力

  • 性价比分析:虽然 Claude Opus 4.7 步数更少,但 GPT-5.4 凭借更低单价,在平均每任务成本上更具优势。前 50 步即可解决 82% 的任务。
  • 小模型赋能:在 Online-Mind2Web 困难子集上,Qwen3.5-9B 结合预构建工具脚本,准确率达到 66.2%。证明小模型在工具增强下也能处理复杂 Web 任务。

生态兼容性与应用

  • 跨平台共享:生成的任务脚本可打包为可重用的 CLI 工具,在 Claude Code、Codex 和 OpenClaw 等代理框架间无缝共享。
  • 开源轻量:框架极简,易于集成和二次开发,支持 Chromium、Firefox 和 WebKit。

相关导航