halo-record
halo-record 是一个开源、轻量级的 Python 库,旨在为 AI 智能体(Agent)提供不可篡改的操作日志记录功能。它通过构建一个仅追加(Append-only)的哈希链日志,确保智能体执行的每一步操作都可被独立验证,且无法被服务提供商或开发者事后修改。这对于满足企业级安全合规要求(如 SOC 2)、建立用户信任以及解决“黑盒”焦虑至关重要。
 Molt
在智能体强化学习(Agent RL)的研究领域,迭代速度往往被庞大的工程复杂度所拖累。传统的 RL 框架动辄数万行代码,每次算法微调都需要深入训练器、分布式后端和复杂的胶水代码中。
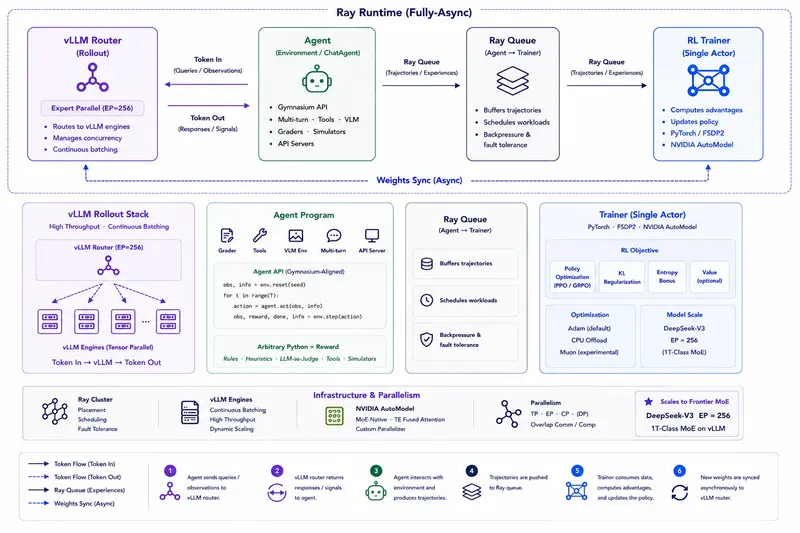
英伟达 NeMo 团队最新发布的 Molt是一个基于 PyTorch 原生的智能体强化学习框架,其核心设计目标极其明确:精简。据官方统计,Molt 的核心 RL 代码量仅为 8.6K 行,相比之下,流行的 Verl 框架约为 62K 行,Slime 为 25K 行。这种极简主义不仅让研究人员能轻松掌握全貌,也让 AI 编程助手能够更有效地辅助代码推理与修改。
Molt 没有重新发明轮子,而是巧妙地组合了三个成熟的开源组件,且均未进行分叉(Fork),确保了上游更新的无缝引入:
这三个组件通过一个紧密耦合的循环协同工作:智能体池持续生成提示,vLLM 引擎处理请求,而可训练的策略参与者则在后台更新。当需要更新模型时,系统会暂停部分推出,通过 NCCL 直接将参与者分片广播到每个引擎,随后恢复保留的请求而非丢弃,从而最大化硬件利用率。
为了确保训练的数学正确性,Molt 引入了三个严格的不变量,其中最具技术挑战性的是针对混合专家(MoE)模型的前向一致性。
在 MoE 模型中,路由器的微小数值差异可能导致 top-k 专家选择的翻转,进而导致推出和训练结果不一致。Molt 采用了**推出路由重放(Inference Routing Replay)**技术:vLLM 在推出时返回每个令牌实际选择的专家 ID,训练阶段则严格重放这些 ID。这确保了训练过程完全基于实际生成的轨迹,消除了因路由器不确定性带来的偏差。
此外,Molt 强调令牌身份:采样得到的令牌 ID 定义轨迹,而非重新分词后的文本。这意味着训练是基于最原始的生成行为进行的,保证了策略版本语义的精确对齐。
Molt 以 Apache 2.0 许可证开源,附带了启动代码、Slurm 脚本和预构建容器。虽然它定位为研究基础设施,但其性能足以支撑前沿实验。
在 Molt 中,智能体被定义为普通的 Python 程序。支持两种主要形式:
step() 循环。