Claude-Ally-Health
Claude-Ally-Health是基于文件系统的个人医疗健康数据管理系统,使用 Claude Code 命令行工具进行数据管理。
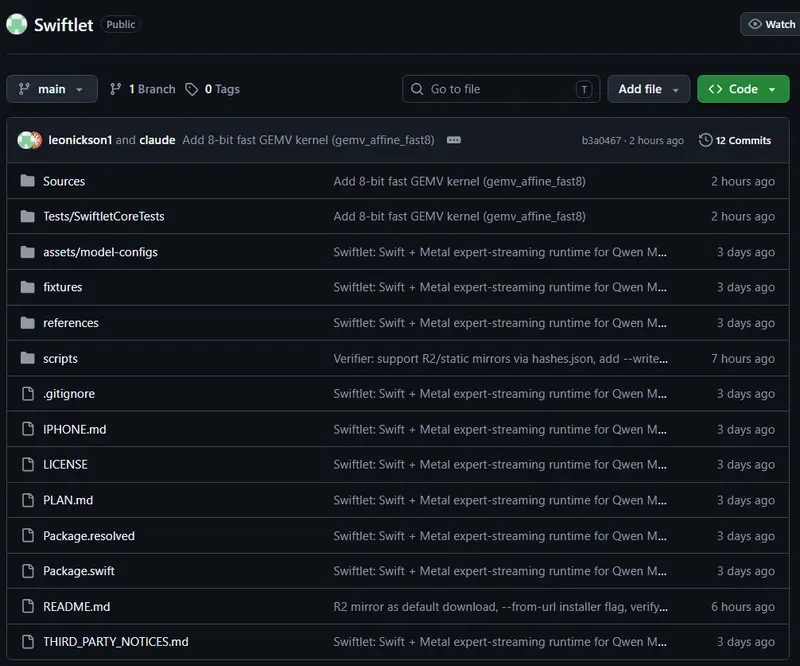
Swiftlet 是一个专为 Qwen3-Next 和 Qwen3.5/3.6 MoE 混合专家模型设计的 Swift + Metal 运行时。它通过将小型稠密核心常驻内存、按需从存储流式加载路由专家权重的方式,使 35B 和 80B 参数规模的模型可在普通 Apple 设备上运行。
 Swiftlet
 是一个专为 Qwen3-Next 和 Qwen3.5/3.6 MoE 混合专家模型设计的 Swift + Metal 运行时。它通过将小型稠密核心常驻内存、按需从存储流式加载路由专家权重的方式,使 35B 和 80B 参数规模的模型可在普通 Apple 设备上运行。
实测数据显示,35B 模型在 M5 Mac 上解码速度为 7–11 tok/s,峰值内存占用仅 2.6 GB;80B 模型速度为 4.5–5 tok/s,内存占用 4.3 GB。35B 模型亦可在 iPhone 17 上以约 1 tok/s 的速度运行,内存占用约 2.5 GB。项目已开源,提供 CLI、Swift 包、本地服务器及 iOS 应用四种接入方式。
Swiftlet 当前支持两个 4-bit 量化模型,具体规格如下:
需明确的能力边界是:每个 token 仅激活约 3B 参数,因此模型在对话生成与写作任务中表现接近大模型,但在事实回忆与知识密集型查询上更接近小模型水平。这一特性源于 MoE 架构本身,而非实现缺陷。当前优化重点在内核调度效率,解码循环尚未达到 IO 瓶颈,仍有提速空间。
Swiftlet 的核心设计围绕减少内存占用与避免页缓存抖动展开:
.qpack 容器中的固定步长 blob,每次专家获取对应一次 SSD pread 调用,不使用 mmap,避免页缓存污染Swiftlet 作为库提供多形态集成选项:
swiftlet chat 用于交互式对话,swiftlet generate 用于单次生成与性能统计,swiftlet-repack 支持从 MLX 检查点或 Hugging Face 直接流式构建容器(含断点续传)swiftlet-server 在环回接口暴露 OpenAI 兼容聊天补全 API,可供任意支持该协议的 UI 调用leonickson1/localLLM 仓库自行构建运行要求为 Apple Silicon 设备、macOS 14+ 或 iOS 17+,以及对应模型的 SSD 空闲空间(35B 需 18 GB,80B 需 42 GB)。模型容器可通过 R2 镜像或 Hugging Face 获取,R2 对匿名下载限速更宽松,推荐优先使用。