Miro
Miro 是一个创新的可视化工作空间,使任何规模的分布式团队能够共同梦想、设计和建设未来。借助 Miro 智能画布™的魔力,团队可以在任何地方可视化概念、想法和解决方案,无需干擦标记。即使在远程、分布式或混合工作环境中,也能与您的团队同步、流畅并感受并肩工作的联系。
 AngelSpec
大语言模型的推理速度一直是落地的瓶颈。为了加速,业界常用的一种技术是“推测解码”(Speculative Decoding):用一个轻量级的“草稿模型”快速预测接下来的几个词,再由强大的“目标模型”一次性验证。如果猜对了,就省去了多次调用大模型的时间;猜错了,再重新生成。
但现有的草稿模型往往试图“通吃”所有场景,结果在对话、代码或数学推理等不同任务上表现平平。腾讯最新开源的 AngelSpec 框架,正是为了解决这个问题而生。它不再追求单一的通用草稿模型,而是针对不同的工作负载,提供了专门优化的训练方案。
推测解码的加速效果取决于两个核心指标:接受率(草稿被目标模型认可的比例)和验证周期耗时。然而,不同领域的文本特性截然不同:
AngelSpec 的核心设计约束就是工作负载的异构性。它提供了两套互补的草稿模型路径,分别针对对话和逻辑推理进行专项优化。
针对对话场景,AngelSpec 对 Hy3 模型原有的 MTP 层进行了重大改进。原始模型在训练时只预测一步,但在推理时却需要循环复用,这导致了“训练-推理不匹配”,错误随深度累积。
AngelSpec 引入了**训练时测试(Test-Time Training)**原则:
这一改进效果显著:在 T=0 时,平均接受率从 52.8% 提升至 66.4%,深层位置的接受率在 GSM8K(数学)和 HumanEval(代码)基准上更是实现了翻倍增长。
针对代码和数学推理,AngelSpec 推出了全新的 DFly 架构,它在 DFlash 基础上进行了两项关键创新:
在 Qwen3-8B 和 Hy3-A21B 上的测试显示,DFly 在数学和代码基准上全面超越了现有的 DSpark 和 DFlash 模型,平均接受长度显著提升。
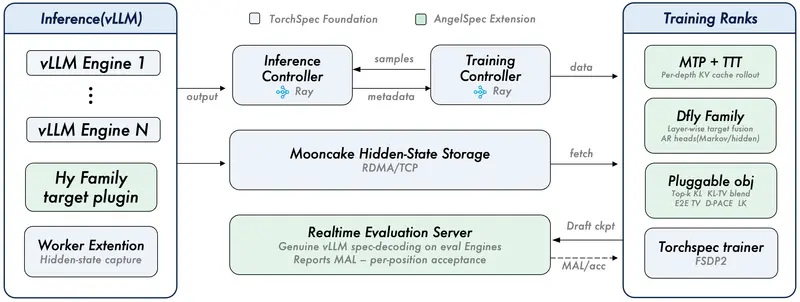
AngelSpec 基于 TorchSpec 构建,并针对大规模训练进行了深度扩展:
目前,AngelSpec 已在 Hugging Face 和 ModelScope 上发布了七个检查点。在实际部署中,DFly-8 在 Hy3-295B-A21B 模型上实现了 1.98–2.40 倍的加速比。对于追求极致吞吐量的场景,其 D-cut 变体甚至能将实时流量吞吐量推至 981 tok/s。
对于希望优化大模型推理成本的开发者而言,AngelSpec 提供了一套配置驱动、高度模块化的解决方案,让推测解码真正适应了复杂的生产环境。