Cua-S1
cua-s1-forms 是一款轻量、对标 Jev(System One)的单遍选项评分模型,定位为 GUI 表单自动填写场景下的决策层,作为 cua-driver 的底层决策核心。它和常规自回归大语言模型存在本质差异:**不输出文本**。输入 UI 界面元素、带类型的候选选项集合(每条实体对应一个选项,额外包含勾选 / 点击 / 跳过动作),模型仅通过一次前向传播输出各个选项的概率,输入输出接口契约和 TypeSafe 的 Jev 保持一致。
 EnvHarness
Google Cloud AI Research 联合圣路易斯华盛顿大学和北卡罗来纳大学教堂山分校的研究团队发布了 EnvHarness。这是一个开源的可编程层,解决 LLM 代理在静态环境中学习效率低下的问题。通过将冻结的基准测试环境包装在动态插件中,EnvHarness 能够根据代理的策略缺陷自动调整训练难度和场景,从而显著提升代理的泛化能力和执行效率。
传统的代理训练依赖于生成新的静态环境,但这往往面临领域特定流水线不可迁移、验证器可信度低等挑战。EnvHarness 反其道而行之:
reset() / step() 接口拦截并重塑状态、动作和观察,实现对环境的“软修改”。EnvHarness 提供了三个可自由组合的插件组件,用于重塑交互过程:
| 组件 | 功能描述 | 示例应用 |
|---|---|---|
| Stage | 重放固定动作列表,改变情节起始状态 | 将目标物品藏在关闭的抽屉中,迫使代理先执行搜索动作 |
| Contract | 安装每步钩子,限制动作或重写观察 | 阻止无效动作、截断冗余观察信息,强制代理更精准决策 |
| Chain | 组合多个环境,共享步骤预算 | 将两个相关任务串联,要求代理在有限步数内完成复合目标 |
EnvRigger 是 EnvHarness 的大脑,它是一个基于 LLM 的设计器循环,负责为特定策略量身定制环境:
整个过程在隔离子进程中运行,确保一次错误的变异不会导致整个系统崩溃。
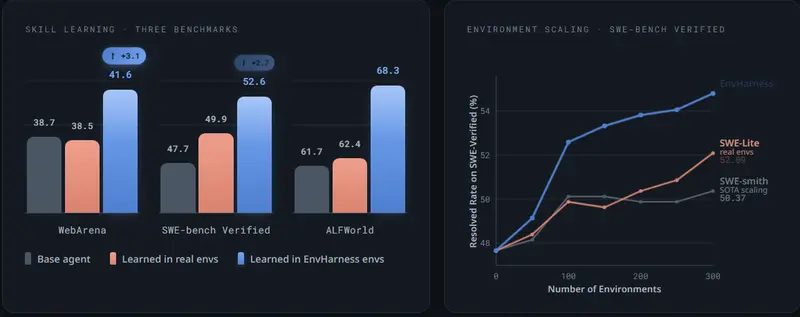
在五个主流基准测试中,EnvHarness 均展现出显著优势:
reset / step / observe / evaluate 等标准接口即可无缝接入,无需修改下游代码。