ToolGrad
Google Research 联合东京大学、RIKEN AIP 和东北大学推出了 ToolGrad,这是一种革命性的工具使用数据生成框架。通过反转传统的“查询优先”流程,ToolGrad 实现了 99.8% 的数据通过率,并仅用 500 个样本就将 Gemma-3-12B 模型的性能提升至与 Gemini 2.5 Pro 相当的水平。
RecursiveMAS 是由伊利诺伊大学厄巴纳-香槟分校 (UIUC) 和 斯坦福大学 研究人员联合开发的创新框架,它允许代理通过嵌入空间(Embedding Space)而非文本直接传递信息,实现了真正的“心灵感应”式协作。
 RecursiveMAS
在当前多代理 AI 系统中,代理间通过生成和共享文本来通信,这不仅导致高延迟和高 Token 成本,更使得系统难以作为整体进行端到端优化。RecursiveMAS 是由伊利诺伊大学厄巴纳-香槟分校 (UIUC) 和 斯坦福大学 研究人员联合开发的创新框架,它允许代理通过嵌入空间(Embedding Space)而非文本直接传递信息,实现了真正的“心灵感应”式协作。
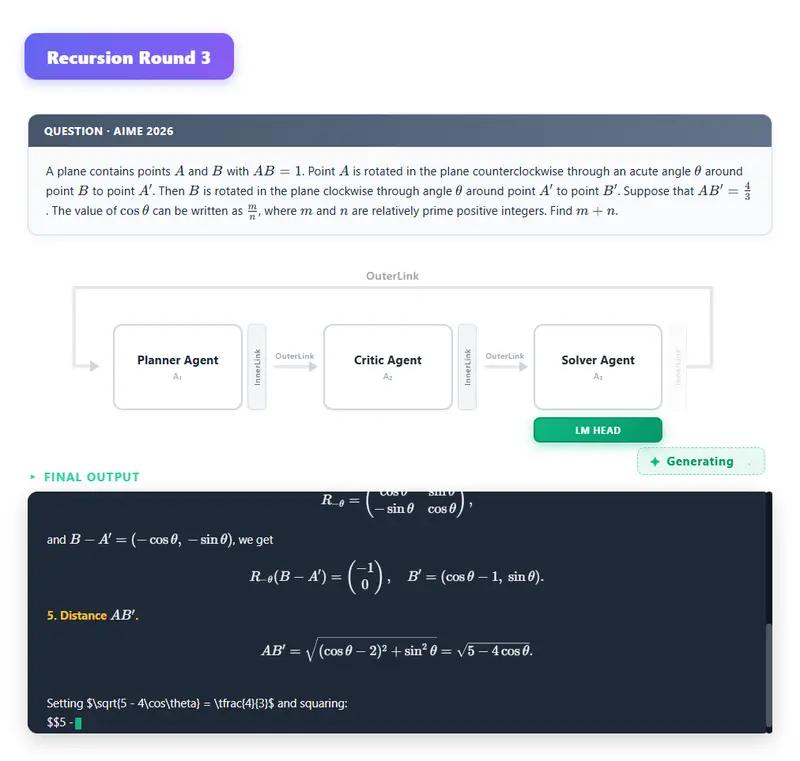
实验表明,RecursiveMAS 在代码生成、医学推理及搜索等复杂任务中,不仅准确率平均提升 8.3%,更将 Token 使用量最高降低 75.6%,推理速度提升 1.2-2.4 倍。其独特的“冻结主干、仅训链接”训练范式,使得构建定制化多代理系统的成本大幅降低,为生产级多智能体应用提供了可扩展、经济高效的蓝图。
为实现跨模型、跨维度的潜在状态传输,研究者引入了轻量级双层模块 RecursiveLink:
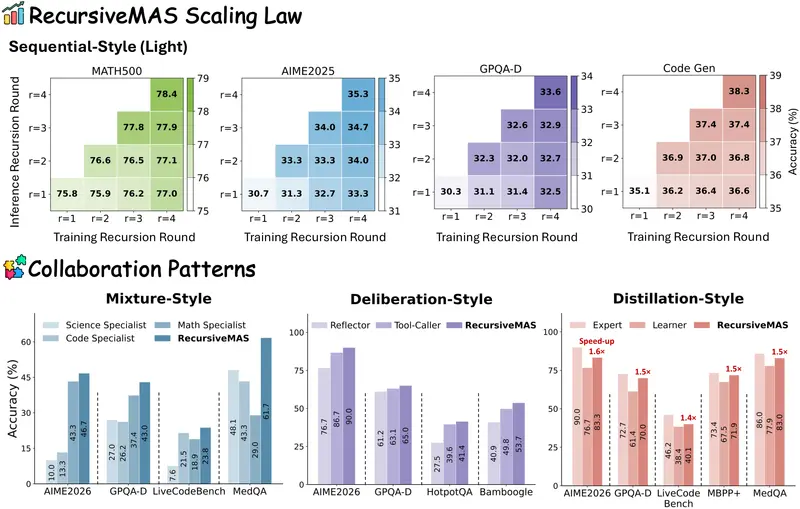
| 指标 | RecursiveMAS | 基于文本的基线 (Recursive-TextMAS) | 提升/优化幅度 |
|---|---|---|---|
| 平均准确率 | SOTA | 次优基线 | +8.3% |
| 推理速度 | 1.2x – 2.4x | 1.0x | 显著加速 |
| Token 消耗 (Round 1) | 65.4% | 100% | -34.6% |
| Token 消耗 (Round 3) | 24.4% | 100% | -75.6% |
| 训练成本 | < 50% | 100% (全量/LoRA) | 减半以上 |
| 峰值显存 | 最低 | 较高 | 大幅降低 |
注:测试模型包括 Qwen, Llama-3, Gemma3, Mistral 等开放权重模型。