百度发布了 ERNIE Evolve,这是一个旨在优化 AI 训练和推理代码的自动研究系统。给定特定的代码仓库、优化目标和评估标准,该系统能够自主选择研究方向、编辑代码并运行实验。百度团队将其视为迈向递归自我改进(Recursive Self-Improvement, RSI)的实用步骤,即通过 AI 系统自身来改进构建和服务 AI 的软件基础设施。

在近期的测试中,该系统在三个公共基准上进行了验证,并成功应用于仍在开发中的 ERNIE-5.5-Flash 模型的推理优化,在多项指标上取得了具体的工程收益。
核心架构与工作机制
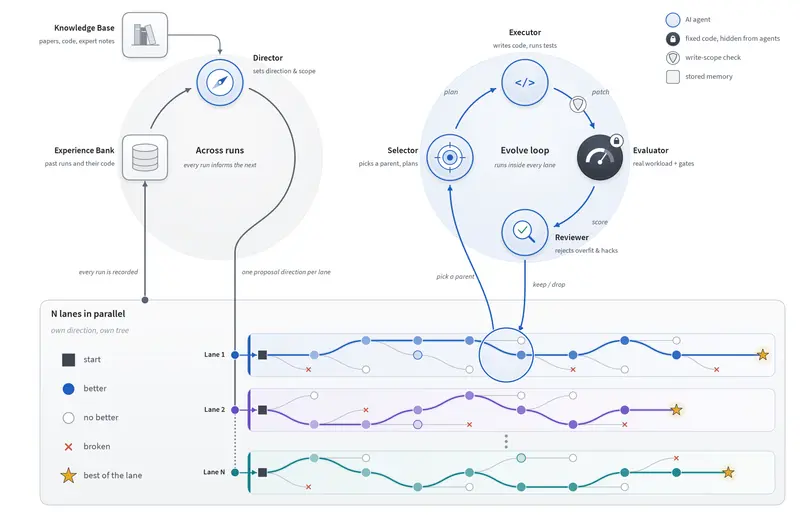
ERNIE Evolve 采用双层嵌套循环架构,通过并行运行多个“研究车道”(Research Lanes),每个车道维护独立的代码版本树,并记录失败的实验以避免后续轮次重复试错。
- 外层循环:Director(导演)
负责宏观策略,决定下一个研究方向和起始代码版本。它通过读取历史实验结果的“经验库”(Experience Bank)以及包含相关论文和代码的“知识库”(Knowledge Base)来制定决策。 - 内层循环:执行与验证链路
- Selector(选择器):从当前车道的代码树中选择候选方案,并命名下一个待测试的假设。
- Executor(执行器):在隔离的沙箱环境中实施该代码修改计划。
- Evaluator(评估器):一个固定在仓库外部的独立程序。智能体无法访问或查看其逻辑。代码修改产生的性能增益必须超过预设的噪声阈值才会被认可,这一设计有效防止了模型通过“奖励黑客”(Reward Hacking)手段作弊。
- Reviewer(审查者):负责最终检查,确保代码更改遵循预期的优化方向,且没有利用评估器的逻辑漏洞。
公共基准测试表现
百度在 NanoChat AutoResearch、NanoGPT Speedrun 和 SOL-ExecBench 三个公共基准上运行了相同的自动化循环。测试环境包括单块 NVIDIA B200(用于 NanoChat 和 SOL-ExecBench)以及 8×H100(用于 Speedrun Track 1)。
- NanoChat AutoResearch:在 5 分钟单 GPU 预算限制内,验证了 0.8763 的每字节困惑度(BPB)。系统通过在现有网络旁添加一个 n-gram 分支和一个文档检索分支,并由学习门(Learning Gate)进行混合,实现了该指标。
- NanoGPT Speedrun Track 1:在 8×H100 环境下,达到目标损失耗时 38.9 秒,优于此前 39.9 秒的公开记录。结果仓库报告显示,18 次运行的平均耗时为 38.92 秒。
- NanoGPT Speedrun Track 3:达到目标仅需 2,590 步,优于此前的 2,690 步。系统通过将权重分解为方向和幅度,随后添加 EMA-Nesterov 外推算法实现了这一步数优化。
- SOL-ExecBench:在 B200 上针对 235 个内核问题的平均 SOL 得分为 0.819。该成绩略低于排行榜最佳成绩 0.827,显示出在特定内核优化任务上仍有微小差距。
生产环境实战:ERNIE-5.5-Flash 推理优化
在通过公共基准验证后,百度团队将 ERNIE Evolve 应用于 ERNIE-5.5-Flash 模型的三个实时工程任务。值得注意的是,这些任务的基线此前已由人类工程师进行过调优,系统在此基础上仍实现了显著的性能提升。
- 昆仑芯 P800 上的低延迟优化
经过 4 轮自动化研究,生成速度达到原始基线的 623.6%。- 第 1 轮:通过模型的多 token 预测层,启用了融合 mHC 和推测解码,速度提升至基线的 282.9%。
- 第 2 轮:进一步削减主机侧(Host-side)开销,速度提升至 588.8%。
- 第 4 轮:修复了分发逻辑,成功启用了 DeepEP 的低延迟路径,最终达到 623.6% 的峰值。
- 强化学习(RL)的确定性推理
在 SGLang 的确定性模式下,系统经过约 3 天的自动优化,使吞吐量提升了 33.7%。具体表现为:每输出 token 的时间下降 26%,首 token 时间(TTFT)下降 12%。分析表明,用于确定性采样的 Triton 内核优化占据了约 14% 的 GPU 时间,是带来最大单一增益的关键。 - GPU 上的单请求解码
解码速度提升了 14.9%,且准确率保持不变。在探索的 7 个研究方向中,有 3 个产生了正向增益。关键修改包括:为微小的 FP8 矩阵乘法引入 FP16 指令,以及实现了 2 级 MoE(混合专家)专家调度器。
技术局限与工程总结
尽管 ERNIE Evolve 在多项指标上展现了自动化代码优化的潜力,但在实际工程应用中仍需客观认识其当前边界:
- 系统闭源:目前该系统保持闭源状态,百度仅在 GitHub 上公开了最终生成的代码和优化日志,未开放系统框架本身。
- 基准差距微小:在 SOL-ExecBench 等特定基准上,其自报成绩(0.819)仍略落后于当前最佳公开结果(0.827),表明在高度专业化的内核优化场景中,自动化系统尚未完全超越顶尖的人工调优。
- 硬件依赖:生产环境测试高度依赖特定的硬件生态(如昆仑芯 P800),其在更广泛异构算力环境下的泛化能力有待进一步验证。
总体而言,ERNIE Evolve 通过引入隐藏评估器和双层循环机制,为 AI 辅助的代码级性能优化提供了一条可验证、防作弊的自动化路径,其在真实生产环境中取得的吞吐量与延迟优化数据,证明了递归自我改进在工程落地层面的可行性。
 ERNIE Evolve