WeChat Mac RPA
WeChat Mac RPA 是一个专为 macOS 设计的微信自动化解决方案。它摒弃了传统的协议逆向、Hook 注入或数据库读取方式,转而采用多模态视觉感知与大语言模型(LLM)Agent 相结合的技术路径。
阿里巴巴正式开源 FlashQLA——一个基于 TileLang 实现的高性能线性注意力算子库。FlashQLA 专为 GDN 设计,通过深度的算子融合与硬件级优化,在 NVIDIA Hopper 架构上实现了相较于主流 FLA Triton Kernel 2-3 倍的前向加速和 2 倍的反向加速。
 FlashQLA
随着 Qwen3-Next 及后续 Qwen3.5/3.6 系列的发布,Gated Delta Network (GDN) 已成为通义千问全系列模型的核心注意力机制。从 80B 到 397A17B 的超大参数规模,再到突破 256K 的超长上下文,GDN 在提供卓越性能的同时,其计算开销在端到端训练与推理中也日益显著。
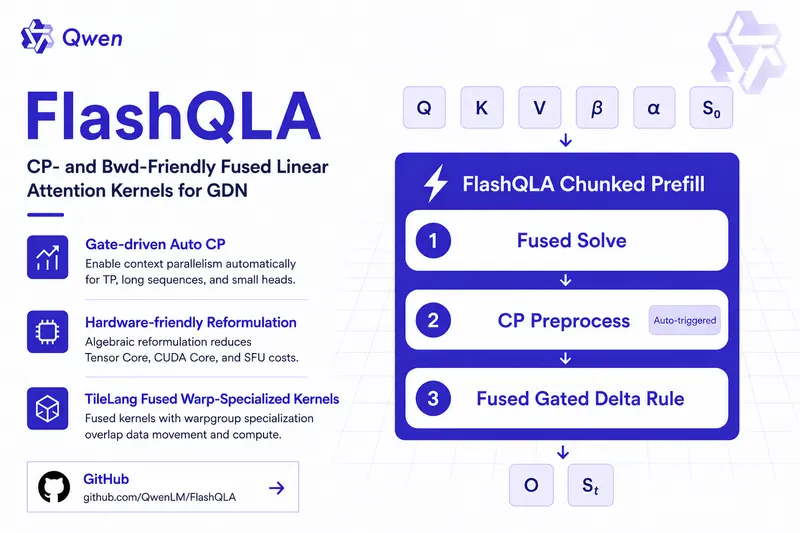
今天,阿里巴巴正式开源 FlashQLA——一个基于 TileLang 实现的高性能线性注意力算子库。FlashQLA 专为 GDN 设计,通过深度的算子融合与硬件级优化,在 NVIDIA Hopper 架构上实现了相较于主流 FLA Triton Kernel 2-3 倍的前向加速和 2 倍的反向加速。
这不仅意味着预训练成本的降低,更标志着端侧 Agentic 推理效率的重大飞跃。
FlashQLA 并非简单的代码重构,而是从算法逻辑到硬件映射的全方位优化。其三大核心技术亮点如下:
GDN 的核心特性在于其 Gate 机制带来的指数衰减性质。FlashQLA 巧妙利用这一数学特性,在以下场景中自动开启卡内序列并行(Intra-card Sequence Parallelism):
通过自动并行化,FlashQLA 显著提高了 GPU SM(Streaming Multiprocessors)的利用率,避免了传统实现中因负载不均导致的算力闲置。
为了适配现代 GPU 的硬件特性,FlashQLA 对 GDN Chunked Prefill 的前向和反向传播流程进行了精细的代数改写。
传统的算子实现往往面临两难:要么拆分为多个独立 Kernel 导致启动开销大,要么融合为一个巨大 Kernel 导致寄存器压力高且难以并行。
FlashQLA 选择了中间路线:
在 NVIDIA Hopper (如 H100/H800) 显卡上的测试表明,FlashQLA 在多场景下均展现出压倒性优势:
| 场景 | 对比基线 (FLA Triton Kernel) | 加速比 |
|---|---|---|
| 前向传播 (Forward) | 标准 Triton 实现 | 2x – 3x 🚀 |
| 反向传播 (Backward) | 标准 Triton 实现 | ~2x 🚀 |
FlashQLA 基于 TileLang 构建,这得益于 TileLang 在高性能算子开发上的独特优势: