Camofox Browser
Camofox Browser 是一个专为 AI Agent 设计的隐形无头浏览器服务器,由强大的 Camoufox 引擎驱动。它通过在 C++ 层面修补 Firefox,从底层伪装 navigator、WebGL、AudioContext 等关键指纹,没有任何 JS 层面的 shim 或包装器痕迹,从而实现真正的“隐形”。
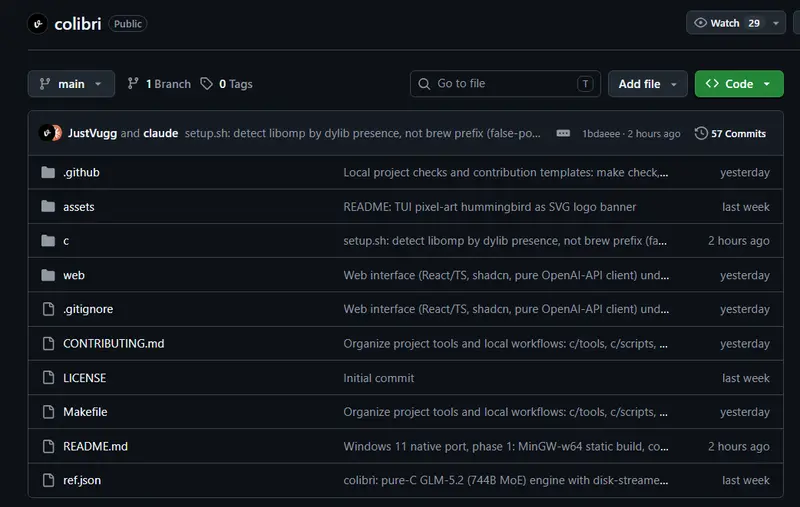
 Colibrì
在英伟达 NVL72 机架动辄数百万美元的今天,普通爱好者如何在本地运行前沿级的大语言模型?
意大利工程师 Vincenzo 给出的答案有些极端,却极具启发性:Colibrì。
这是一个概念验证项目,它成功地在仅配备 25GB RAM、普通 CPU 和虚拟 NVMe 驱动器的家用电脑上,运行了参数量高达 7440 亿、体积达 1.5TB 的 GLM-5.2 模型。
虽然速度慢得令人发指,但它证明了一件事:只要架构得当,巨大的模型并非只能存在于数据中心。
Colibrì 的核心智慧在于对 混合专家(MoE, Mixture of Experts) 架构的极致利用。
GLM-5.2 这样的 MoE 模型包含数百个“专家”子网络。在处理输入时,模型并非激活所有参数,而是按 Token 选择最相关的几个专家。
Colibrì 的工作流程如下:
为了保持轻量,Colibrì 的核心逻辑仅由一个极少依赖的 C 文件构成,并对模型进行了量化处理以进一步减小体积。
理想很丰满,现实很骨感。
在 Vincenzo 的测试环境中,Colibrì 的平均推理速度仅为 0.05 到 0.1 token/秒。这意味着生成一个简单的句子可能需要几分钟,回答一个复杂问题则需数小时。这与实时对话所需的 20-30 token/秒相去甚远。
瓶颈在哪里?
值得注意的是,目前 Colibrì 仅在 CPU 上运行。即便未来引入 GPU,显卡与内存/硬盘之间的数据交换(PCIe 带宽)很可能成为新的瓶颈。
尽管目前不具备实用价值,Colibrì 的出现仍具有重要意义: