llm-d

5天前发布 16 00

Google Cloud 联合 Red Hat、IBM、CoreWeave 和 NVIDIA 等组织,近日正式发布了 llm-d 1.0。作为 CNCF Sandbox 项目,这是该分布式推理栈的首个稳定版本(v1 API)。它旨在将 vLLM 或 SGLang 等模型服务器转变为高度协调的计算池,专门解决自托管 AI 代理和强化学习(R...

所在地:
谷歌
收录时间:
2026-10-23
其他站点:

Google Cloud 联合 Red Hat、IBM、CoreWeave 和 NVIDIA 等组织,近日正式发布了 llm-d 1.0。作为 CNCF Sandbox 项目,这是该分布式推理栈的首个稳定版本(v1 API)。它旨在将 vLLM 或 SGLang 等模型服务器转变为高度协调的计算池,专门解决自托管 AI 代理和强化学习(RL)工作负载中传统轮询负载均衡失效的问题。
llm-d

核心架构与技术特性

llm-d 1.0 建立在 Kubernetes Gateway API Inference Extension 之上,提供了一系列针对大规模推理优化的企业级功能:

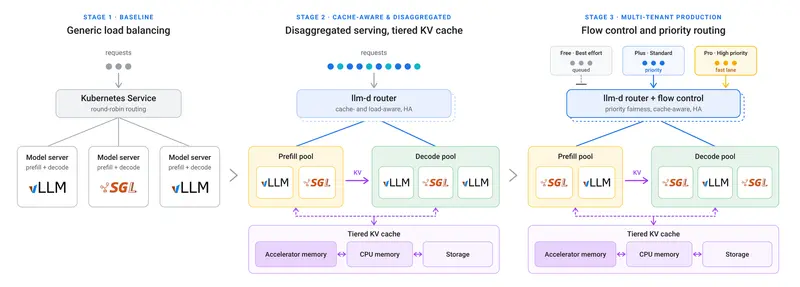
  • 缓存感知路由:路由器实时跟踪哪些副本持有特定的缓存前缀。在调度请求时,它会综合权衡当前负载与预测延迟,确保代理调用能精准落在已包含其上下文数据的节点上,从而最大化缓存命中率。
  • 分层 KV 缓存卸载:当加速器(如 GPU/TPU)内存饱和时,系统会自动将 KV 缓存降级至主机内存、SSD 或 Managed Lustre 文件系统。该机制兼容 vLLM 的 OffloadingConnector、Mooncake 以及 SGLang 的 HiCache。
  • 预填充与解码分离(P/D Separation):鉴于预填充阶段计算密集而解码阶段内存受限,llm-d 支持将两者作为独立的资源池运行,并通过 DisaggregatedSet 实现两者的协同滚动升级,确保零停机。
  • 多租户 QoS 与代理感知:引入优先级和公平感知的流控制,防止突发流量饿死延迟敏感型请求。同时支持会话感知路由、轮次优先级调度及原生 Responses API 状态管理。
  • 异步推理与 TPU 扩展:通过 llm-d-async-processor 从 Pub/Sub 或 Redis 拉取任务至空闲算力;并借助 TorchTPU 在上游 vLLM 和 SGLang 中实现 PyTorch 模型的原生 TPU 支持。

性能基准与实测表现

根据 Google 及早期采用者自报的数据,llm-d 在生产环境中展现出显著的性能收益:
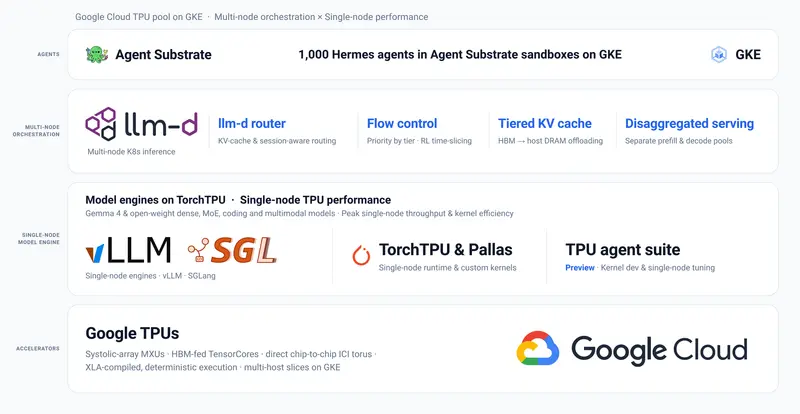
  • Ironwood TPU (TPU v7):结合前缀感知路由与主机内存卸载,中位首字延迟(TTFT)降低超 85%,整体吞吐量较普通 Kubernetes Service 提升 2.4 倍。
  • Gemini 平台:前缀缓存命中率从 35% 翻倍至 70%,编码代理的 TTFT 下降超 35%,突发聊天场景下的 P95 TTFT 下降超 50%。
  • 大规模扩展:在 17,000 节点的跨多区域 GKE 基准测试中,吞吐量扩展了 2.9 倍,同时保持 99.9% 的成功率且系统开销低于 1%。
  • A3 Mega (70B 模型):在 50k token 的长提示词场景下,Lustre 加 CPU RAM 卸载使 TTFT 改善约 40%,端到端延迟下降 30%,GPU 小时消耗减少近 60%。
  • 行业采用反馈:Snap 报告前缀缓存命中率达 75%-80%;Zenteiq 报告吞吐量提升超 4 倍;IBM 演示表明,该方案能以低于公有云 API 定价 5 至 10 倍的成本服务 3,000 个并发编码代理。
llm-d

生态对比与部署路径

在开源推理编排领域,llm-d 与 NVIDIA Dynamo 和 AIBrix 形成互补而非绝对竞争关系。相较于主要聚焦 NVIDIA GPU 的 Dynamo,llm-d 凭借 CNCF 的开放治理,提供了对 AMD、Intel GPU 及 Google TPU 的更广泛原生支持,并深度集成了 Kubernetes 生态(如 KEDA、HPA 和 Kueue)。

对于计划引入 llm-d 的团队,Google 建议采用分阶段的迁移路径:

  1. 第一阶段:在现有的 vLLM 部署前端引入前缀感知路由,快速获得缓存命中收益。
  2. 第二阶段:逐步启用流控制、分层 KV 缓存卸载以及预填充/解码分离,以应对更复杂的并发和长上下文场景。

目前,llm-d 可通过 GKE Inference Gateway 作为托管服务直接运行,支持跨集群和区域的全局故障转移;自托管用户也可通过官方验证的 Helm charts 快速部署 TPU 和 GPU 混合池。

相关导航