Edit Anything
Edit Anything 是一组基于 LTX-2.3 模型构建的实验性 LoRA,旨在探索视频内容的精细化编辑能力。该套件包含三个独立的训练轨迹,分别针对运动迁移、无参考多任务编辑以及参考图像驱动的视频到视频转换。
在视频后期制作中,移除前景遮挡物(如栏杆、树叶、人群)或透过烟雾/薄雾还原清晰背景,一直是一项极具挑战性的任务。Obscura Remova 是一个专为 LTX 2.3 模型设计的 Video-to-Video (V2V) LoRA,旨在解决这一痛点。
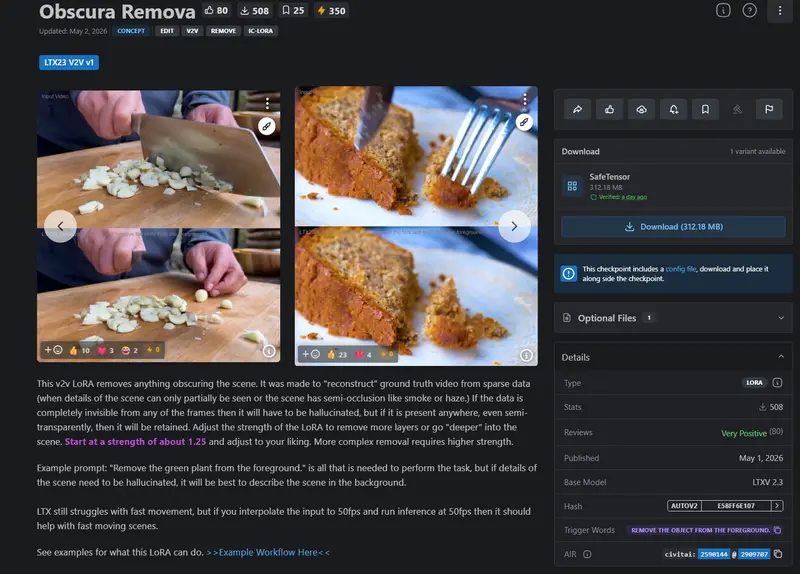
它不仅能简单地“擦除”物体,更能基于视频中保留的稀疏视觉数据,智能重建被遮挡的背景细节,实现自然且连贯的视频修复效果。
Obscura Remova 的设计哲学并非简单的“幻觉填补”,而是**“数据保留与重建”**:
"remove the green plants in the foreground"(移除前景中的绿色植物)"remove the green plants in the foreground, reveal the clear blue sky and the mountain behind"(移除前景绿植,展现后方清晰的蓝天和山脉)LTX 模型在处理高速运动时可能会出现伪影或闪烁。为了优化 Obscura Remova 在动态场景下的表现: