crtanim

231 00

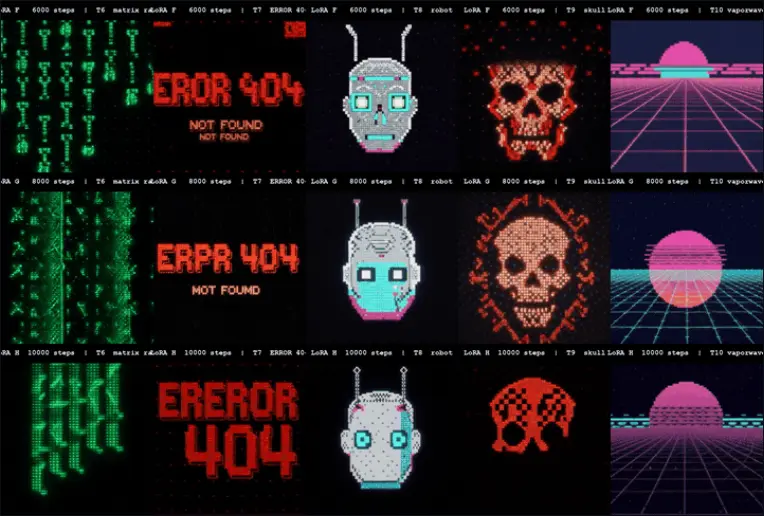
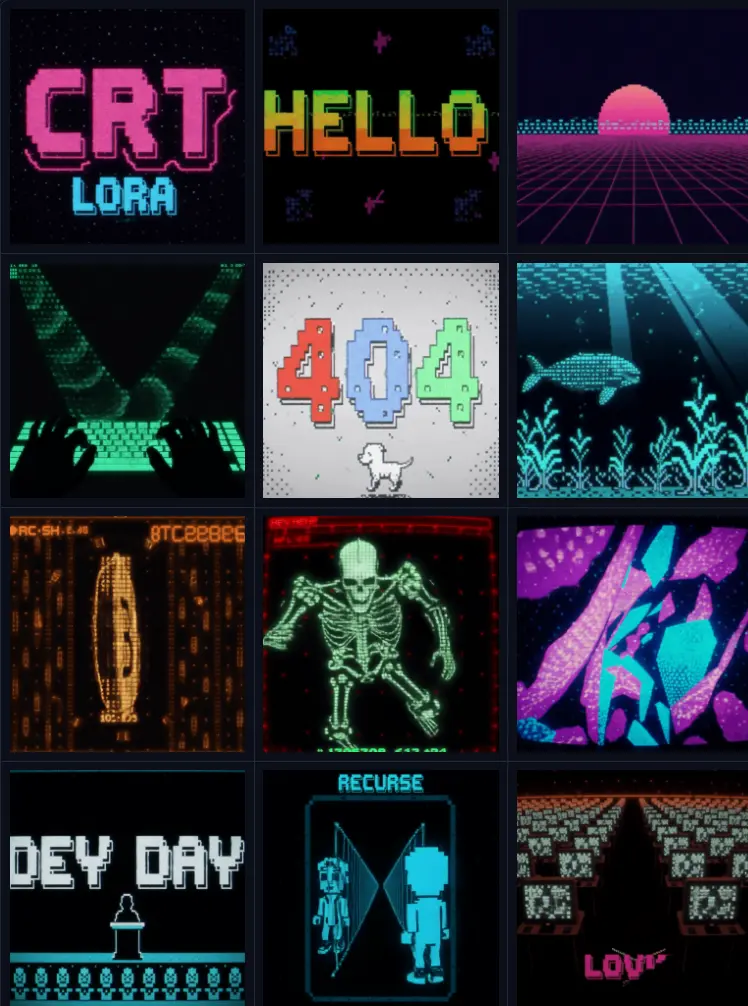
crtanim 是一款专为 LTX-2.3 22B 视频生成模型设计的开源 LoRA。它能将生成的视频内容完美复刻 80 年代末至 90 年代初的 CRT 显示器美学,包括扫描线、磷光余辉、色差、桶形畸变、信号噪声以及特有的低帧率卡顿感。

作者
lovis93
触发词
crtanim
基础模型
LTX 2.3
系列
crtanim

crtanim 是一款专为 LTX-2.3 22B 视频生成模型设计的开源 LoRA。它能将生成的视频内容完美复刻 80 年代末至 90 年代初的 CRT 显示器美学,包括扫描线、磷光余辉、色差、桶形畸变、信号噪声以及特有的低帧率卡顿感。

crtanim

该 LoRA 在 fal.ai 平台上训练完成,兼容任何支持标准 .safetensors 格式的 LTX-2.3 22B 运行时(如 ComfyUI, fal.ai 等)。

核心视觉效果

  • 扫描线与网格:模拟 CRT 屏幕的物理结构。
  • 磷光余辉 (Phosphor Glow):字符和高亮部分的发光与拖尾效果。
  • 色差 (Chromatic Aberration):边缘的红蓝色彩分离。
  • 桶形畸变:屏幕边缘的自然弯曲。
  • 信号噪声与抖动:模拟老式信号的不稳定性。
  • 低帧率运动:特有的“卡顿”感,增强复古氛围。
crtanim

模型下载

提供两个检查点版本,均已是 ComfyUI 兼容格式,直接放入 ComfyUI/models/loras/ 即可使用。

文件名训练步数特点与推荐用途下载链接
crtanim_10000.safetensors10,000推荐。文字更清晰,结构更锐利,适合需要可读文本的场景。Download
crtanim_4000.safetensors4,000运动更宽松、更具表现力,适合抽象或动态强烈的场景。Download

提示词配方 (Prompt Recipe)

为了获得最佳效果,请严格遵循以下结构:

crtanim + [CRT 美学描述] + [调色板] + [动画风格] + [主体] + [构图] + [字面文本(用引号括起)] + [情绪]

✅ 成功示例

crtanim, a CRT aesthetic with scanlines, green phosphor glow, bloom, chromatic aberration, a terminal typing out exactly "$ ls -la" character by character in glowing green blocky pixel font, a blinking cursor below, static centered composition, low choppy frame rate, hacker mood.

关键技巧

  1. 触发词置顶:必须将 crtanim 作为提示词的第一个词。
  2. 文本简短:屏幕上的文字最好控制在 1-3 个单词或短命令(如 ACCESS DENIED, LOADING...),过长文本容易变形。
  3. 负面提示词:如果希望文字可读,请务必覆盖默认的负面提示词,避免模型过度平滑化导致文字模糊。
  4. 构图控制:该 LoRA 倾向于静态构图。如果需要相机运动(如推拉摇移),必须在提示词中明确说明(例如 slow zoom in)。

注意事项

  • 实验性发布:这是首次公开发布,文本渲染和运动的稳定性可能因提示词而异,可能需要多次生成以获取最佳结果。
  • 文本渲染:虽然针对终端文字进行了优化,但复杂字体或长句子仍可能出现伪影。
  • 运动风格:默认运动较为僵硬(符合 CRT 特性),若需流畅运动需额外强调。

训练细节

  • 基础模型: LTX-2.3 22B
  • 训练平台: fal-ai/ltx23-video-trainer
  • 宽高比: 1:1
  • 学习率: 2e-4
  • 数据集: 精选的小型 CRT / 像素艺术视频片段集

相关图书

Obscura Remova

Obscura Remova

Obscura Remova 是一个专为 LTX 2.3 模型设计的 Video-to-Video (V2V) LoRA, 它不仅能简单地“擦除”物体,更能基于视频中保留的稀疏视觉数据,智能重建被遮挡的背景细节,实现自然且连贯的视频修复效果。
Edit Anything 

Edit Anything 

Edit Anything 是一组基于 LTX-2.3 模型构建的实验性 LoRA,旨在探索视频内容的精细化编辑能力。该套件包含三个独立的训练轨迹,分别针对运动迁移、无参考多任务编辑以及参考图像驱动的视频到视频转换。
Ltx2.3-VBVR-lora-I2V

Ltx2.3-VBVR-lora-I2V

LiconStudio 正式推出了针对 LTX-2.3 (22B) 基础模型的 VBVR LoRA 微调权重。这一更新旨在解决当前视频生成模型在复杂逻辑、物理规律和多物体交互方面的短板,通过引入 VBVR 数据集进行专项训练,显著提升了模型对因果律、空间关系和运动动态的理解与生成能力。