Edit Anything 

205 00

Edit Anything 是一组基于 LTX-2.3 模型构建的实验性 LoRA,旨在探索视频内容的精细化编辑能力。该套件包含三个独立的训练轨迹,分别针对运动迁移、无参考多任务编辑以及参考图像驱动的视频到视频转换。
作者
Alissonerdx
触发词
基础模型
 LTX-2.3
系列
Edit Anything 

Edit Anything 是一组基于 LTX-2.3 模型构建的实验性 LoRA(Low-Rank Adaptation)权重,旨在探索视频内容的精细化编辑能力。该套件包含三个独立的训练轨迹,分别针对运动迁移、无参考多任务编辑以及参考图像驱动的视频到视频转换。

Edit Anything 

⚠️ 重要提示:这些模型仍处于研究实验阶段,远未达到生产就绪状态。它们在许多输入上可能会失败,旨在供社区测试、探索和反馈,而非作为成品工具使用。

套件概览

该仓库托管了以下三个主要版本:

1. Edit Anything v0.1 — 运动迁移 LoRA

  • 文件:edit_anything_30k_v0.1_motion_transfer_r128.safetensors / r256
  • 核心功能:运动迁移。允许用户将一段引导视频的运动模式应用到一张静态编辑图像上。
  • 工作原理:
    • 阶段 1:纯图像预训练(约 30,000 对图像编辑对)。
    • 阶段 2:视频微调,恢复时间先验并解锁运动迁移行为。
  • 使用方法:选取一个引导视频,将其首帧替换为编辑后的静态图像,并将原始引导视频作为运动来源。
  • 局限性:硬场景切换或极快速度运动会失效;首帧混合不佳会导致伪影传播。
  • 秩选择:
    • r128 (1.31 GB):保持率 ~99.4%。
    • r256 (2.62 GB):保持率 ~99.9%,更接近源模型表现。

2. Edit Anything — 无参考多任务 LoRA

  • 文件:edit_anything_v1.1_r256.safetensors
  • 核心功能:纯提示驱动的多任务编辑。无需参考图像,仅通过文本提示和引导视频完成添加、移除、替换或风格化。
  • 特点:
    • 在更大、更均衡的视频对数据集上精炼。
    • 秩为 256,提供更大容量以处理复杂任务组合。
    • 直接基于视频对训练,时间一致性更稳定。
  • 提示词指南:
    • 添加:需详细描述(15-30+ 词),如“在新闻台男士右侧添加一位微笑的棕发女士…”。
    • 移除:简短指令(4-10 词),如“移除正在喝水的男士”。
    • 替换:描述新旧对象(20-35 词),如“将白色板门替换为深棕色落地钟”。
    • 风格:固定模板,如“转换为铅笔素描风格”。
  • 不支持:组合提示(如同时添加和移除)、独立背景更改、全局光照/色彩分级。

3. 参考视频到视频 (Ref V2V) — 实验性 IC-LoRA

  • 文件:包含 .standard.safetensors 和 .module.safetensors 侧载文件。
  • 核心功能:参考图像驱动。明确使用参考图像作为外观来源进行添加或替换。
  • 架构创新:传统 IC-LoRA + 额外投影分支:
    • ref_visual_proj:将参考 VAE 潜在空间投影到视觉记忆令牌。
    • ref_attn:专用交叉注意力分支。
    • ref_adaln_proj:源自参考的全局 AdaLN 偏置。
  • 加载要求:必须同时加载标准文件和模块侧载文件,并通过 BFSnodes 自定义节点连接。

推理与工作流

所有推荐的推理路径均依赖 BFSnodes ComfyUI 自定义节点集。

关键节点

  • LTXVEditAnythingApply:加载 LoRA 及额外组件并修补模型。
  • 🅛🅣🅧 LTXV Edit Anything Looping Sampler:注入角色/AdaLN/视觉交叉注意力,并分块处理长视频。
  • LTXVEditAnythingModuleLoader:专门用于加载 .module.safetensors 侧载文件。
调优技巧:CFG 值的重要性

  • 提高 CFG (>1.0):如果模型忽略提示词,提高 CFG 是最常见的修复方法,但会显著降低生成速度。
  • 降低 CFG:如果结果出现过饱和、塑料感或运动冻结,说明 CFG 过高。

快速开始建议

  1. 环境准备:安装 ComfyUI 并配置 BFSnodes 自定义节点。
  2. 选择模型:
    • 想做动作重演?选 v0.1 Motion Transfer。
    • 想通过文字修改内容?选 v1.1 No-Reference。
    • 想指定外观参考?选 Ref V2V(需复杂节点设置)。
  3. 编写提示:根据所选模型的提示词风格严格编写描述,避免模糊指令。
  4. 调整参数:从默认 CFG 开始,根据输出质量微调。

相关图书

Obscura Remova

Obscura Remova

Obscura Remova 是一个专为 LTX 2.3 模型设计的 Video-to-Video (V2V) LoRA, 它不仅能简单地“擦除”物体,更能基于视频中保留的稀疏视觉数据,智能重建被遮挡的背景细节,实现自然且连贯的视频修复效果。
Ltx2.3-VBVR-lora-I2V

Ltx2.3-VBVR-lora-I2V

LiconStudio 正式推出了针对 LTX-2.3 (22B) 基础模型的 VBVR LoRA 微调权重。这一更新旨在解决当前视频生成模型在复杂逻辑、物理规律和多物体交互方面的短板,通过引入 VBVR 数据集进行专项训练,显著提升了模型对因果律、空间关系和运动动态的理解与生成能力。
crtanim

crtanim

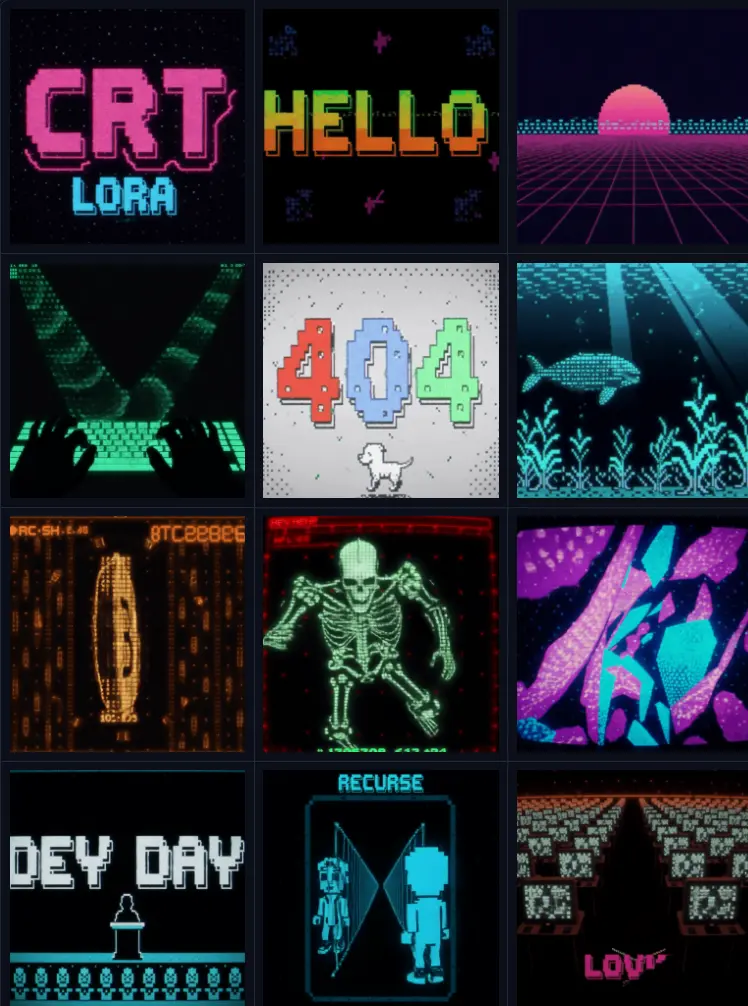
crtanim 是一款专为 LTX-2.3 22B 视频生成模型设计的开源 LoRA。它能将生成的视频内容完美复刻 80 年代末至 90 年代初的 CRT 显示器美学,包括扫描线、磷光余辉、色差、桶形畸变、信号噪声以及特有的低帧率卡顿感。