llama.cpp - 最新版
llama.cpp 是一个轻量、高效的开源 AI 项目,适合在各种硬件上运行 LLM,提供丰富的工具和后端支持,开发者可通过 CLI 和 HTTP 服务器轻松使用。它支持模型微调、量化技术,并与 Hugging Face 和 ModelScope 等平台无缝集成,是构建 AI 应用程序的理想选择。
oMLX 是一款专为 Apple Silicon Mac 设计的原生 LLM 推理服务器与管理工具。它解决了本地运行大模型时在“便利性”与“可控性”之间的权衡难题,通过独特的分层 KV 缓存(热 RAM + 冷 SSD)技术和连续批处理能力,让本地 LLM 在配合 Claude Code 等 AI 编程助手进行长上下文编码任务时变得真正可用且高效。
764MB0 人已下载 手机查看
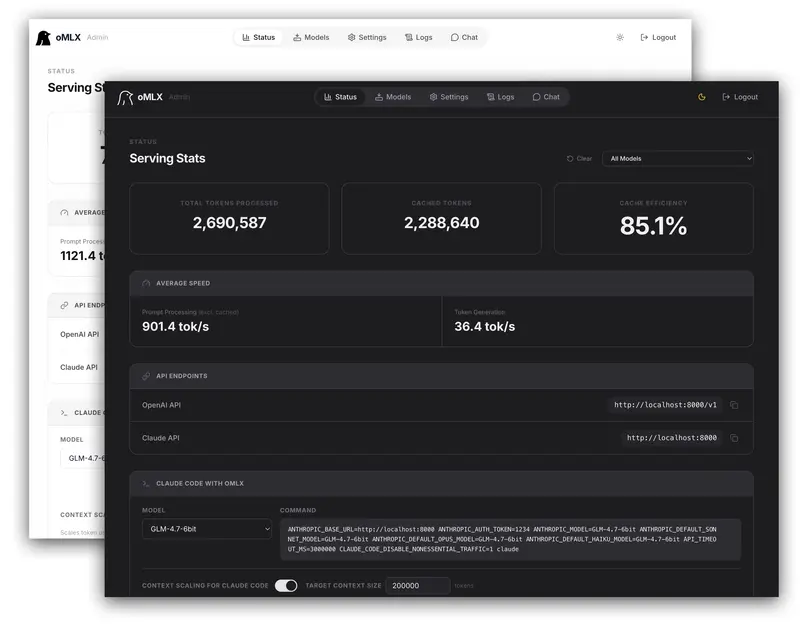
oMLX 是一款专为 Apple Silicon Mac 设计的原生 LLM 推理服务器与管理工具。它解决了本地运行大模型时在“便利性”与“可控性”之间的权衡难题,通过独特的分层 KV 缓存(热 RAM + 冷 SSD)技术和连续批处理能力,让本地 LLM 在配合 Claude Code 等 AI 编程助手进行长上下文编码任务时变得真正可用且高效。
safetensors 格式转存至 SSD。下次请求命中相同前缀时,直接从磁盘恢复,无需重新计算。即使服务器重启,历史上下文依然保留,极大提升了长对话和代码库理解的效率。mlx-lm 的 BatchGenerator,支持并发处理多个请求,最大化 GPU 利用率。/admin 界面,支持多语言(含中文)、模型下载、基准测试、聊天调试及详细配置。完全离线可用,无 CDN 依赖。系统 RAM - 8GB,防止系统级 OOM。qwen3-8b:thinking),无需额外内存即可切换采样参数或模板。.dmg 文件,拖入 Applications 文件夹。omlx serve --model-dir ~/modelshttp://localhost:8000/v1http://localhost:8000/admin/chat