Open WebUI - 最新版
Open WebUI 是一个功能丰富的开源工具,适合开发者、研究人员和组织,用于构建自定义 AI 聊天界面。其支持多种 LLM、插件扩展和自托管能力使其在 AI 交互领域具有吸引力。
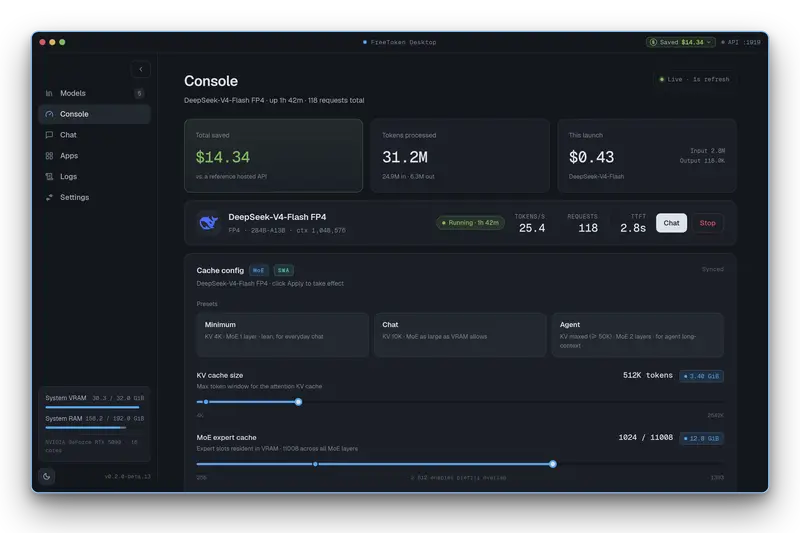
FreeToken 是一个革命性的边缘原生混合专家(MoE)服务引擎,由加州大学伯克利分校和德克萨斯大学奥斯汀分校的研究团队开发。它打破了“运行前沿大模型需要数据中心集群”的传统假设,通过将个人机器上的异构资源(GPU、CPU、内存、互连带宽)视为一个统一的弹性推理平台,实现了在消费级硬件上高效运行超大规模开放权重模型的目标。
其最惊人的成就包括:在 8GB 显存的笔记本电脑 GPU 上以交互速度运行 35B 模型,在游戏台式机上运行 284B 模型,甚至在单张工作站显卡上运行高达 753B 参数的 GLM-5.2。
现有的推理引擎(如 llama.cpp, Ollama, KTransformers)在处理 MoE 模型时面临预填充慢、解码流量分配不均以及 CPU 带宽瓶颈等问题。FreeToken 通过三种创新机制解决了这些难题:
FreeToken 在多种硬件配置下均展现出超越现有基线(llama.cpp, Ollama, KTransformers)的性能:
| 硬件环境 | 模型 | FreeToken 性能 | 对比基线提升 |
|---|---|---|---|
| RTX 5090 | Qwen3.6-35B-A3B (BF16) | 77–83 tok/s | 1.5–2.3 倍于最强基线 |
| RTX 5090 | DeepSeek-V4-Flash (MXFP4) | 22–25 tok/s | 尾部 TTFT < 44s (基线高达 946s) |
| RTX 4060 (8GB) | Qwen3.6-35B (NVFP4) | 39.3 tok/s | 高于 Codex生产中位解码速度 (33 tok/s) |
| RTX PRO 6000 | GLM-5.2 (753B) | 14.9 tok/s | 2 倍于 llama.cpp (7.3 tok/s) |
注:在代理工作负载中,FreeToken 的解码速度波动控制在单轮速率的 12% 以内,确保了稳定的交互体验。
uv pip install "freetoken[accel]"ft serve 在端口 1919 暴露 OpenAI 和 Anthropic 兼容端点。ft launch claude 可直接将 Claude Code, Codex, OpenCode 等代理连接到本地 FreeToken 实例。