腾讯混元团队今日正式发布全新大语言模型 Hy4 Flash。该模型被官方定位为“迄今为止性价比最高的 Hy 系列模型”,在保持强劲智能水平的同时,通过架构创新与推理优化大幅降低了使用成本。Hy4 Flash 总参数量达 2240 亿(224B),支持多模态输入及 100 万 Token 超长上下文,旨在为日常办公、文档处理及轻量级 Agent 任务提供高效、经济的 AI 解决方案。
核心架构:Engram 参数与 LatentMoE
Hy4 Flash 的高性能源于其在预训练、后训练及推理三个阶段的协同优化:
- 混合架构设计:模型引入混合注意力机制、LatentMoE 以及 Engram 模块。Engram 是一种可扩展的查表式参数模块,能以极低的算力成本扩充模型容量。
- 稀疏激活:虽然总参数量为 224B(含 64B Engram 参数),但每个 Token 仅激活 12B 参数,显著提升了计算效率。
- KV Cache 优化:相比 Hy3,KV Cache 大小降至 1/24;相比 Hy4,降至 1/6,极大降低了长上下文处理的显存占用。
极致性价比:成本大幅下调
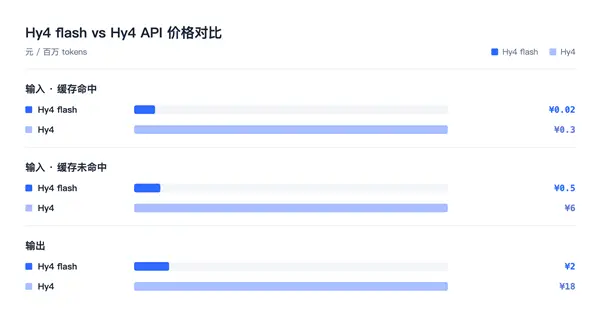
腾讯官方数据显示,Hy4 Flash 在成本控制上取得了突破性进展:
| 对比对象 | 单任务成本比例 | 备注 |
|---|---|---|
| Hy4 Preview | 1/13 | 显著低于早期预览版 |
| Hy4 (正式版) | 1/20 | 成本仅为旗舰模型的 5% |
| DeepSeek-V4.1-Flash | 1/8 | 相比竞品忙时价格更具优势 |
在推理速度方面,结合 megakernel、4bit 量化和 dflash 等技术,Hy4 Flash 的解码速度超过 150 tokens/s,支持大规模低成本部署。此外,通过后训练阶段的自蒸馏与强化学习,其端到端任务输出长度压缩了 50%,进一步减少了 Token 消耗。
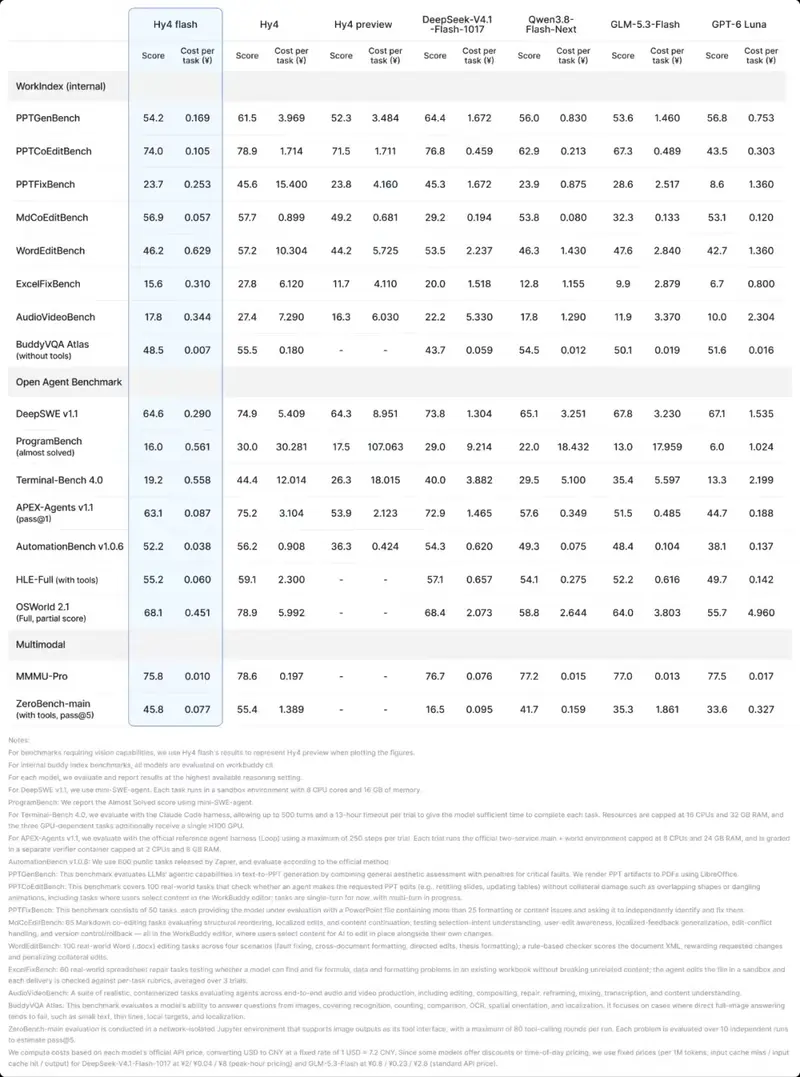
性能表现:媲美 Claude Haiku 5.5
在腾讯内部构建的 WorkIndex 评测集(侧重日常工作产物效果、输出长度与端到端用时)中,Hy4 Flash 的综合效果略优于 Hy4 Preview。
一项涉及 85 位内部用户、覆盖 27 类共 259 个日常工作任务的盲测结果显示:
- 用户满意度:接近 Claude Haiku 5.5 的水平。
- 任务时长:在所有参与对比的模型中最短。
- 成本优势:单任务成本显著低于所有竞品。
应用场景与产品接入
腾讯建议将 Hy4 Flash 应用于以下高频、对响应速度敏感的场景:
- 深度搜索与信息提取
- 文档处理与总结
- PPT 生成
- 简单前端页面展示
- Computer Use(基础操作)
对于长程软件工程等极高复杂度任务,仍推荐使用智能上限更高的 Hy4 旗舰模型。
目前,Hy4 Flash 已全面接入腾讯系核心产品,包括 腾讯云 TokenHub、WorkBuddy、元宝、企业微信、QQ、ima 及 Marvis,并即将上线 OpenRouter。
限时优惠与开源计划
- WorkBuddy:2026 年 11 月 30 日前限时免费使用。
- 腾讯云 TokenHub API:限时享受 5 折 优惠。
- 开源承诺:腾讯混元团队表示计划开源 Hy4 Flash,并保持高频迭代,以促进社区生态发展。
Hy4 Flash 的发布,标志着腾讯混元在平衡模型性能与推理成本方面迈出了关键一步,为企业和个人开发者提供了一个极具竞争力的日常 AI 基础设施选项。
© 版权声明
文章版权归作者所有,未经允许请勿转载。