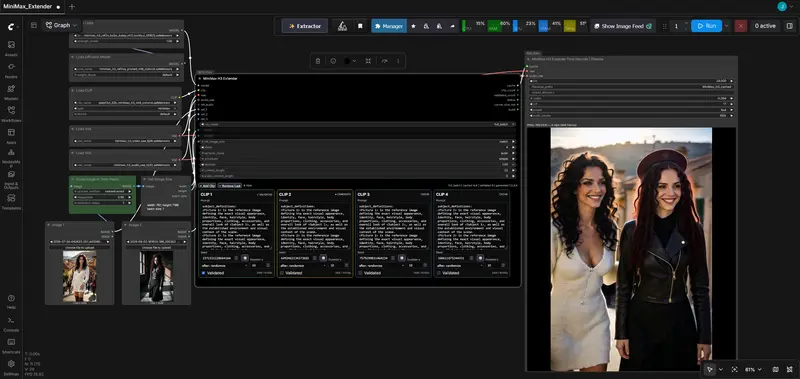
H3-Character-Sheet-Designer 是一款专为 ComfyUI 环境设计的自定义节点,利用原生 MiniMax H3 图像参考条件生成标准化的角色参考表。该工具支持输入一张核心角色图像及最多三个可选部件参考,可生成包含头部、全身、服装正背面及手脚细节的多视图组合。近期发布的 v1.3 版本在布局控制、UI 交互及工作流模板上进行了针对性的工程调整。
- GitHub:https://github.com/ukr8b3g-cmyk/H3-Character-Sheet-Designer
v1.3 核心功能与参数调整
- 版本化节点并存:系统现同时注册
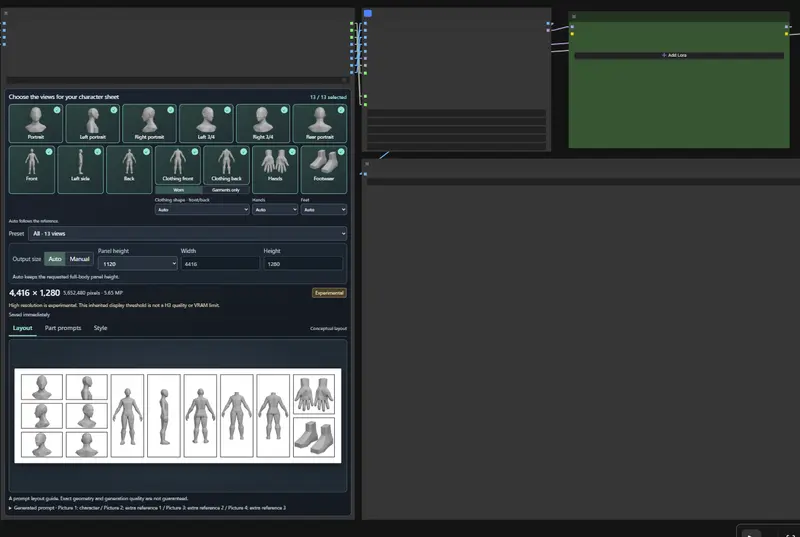
v1.3.0和v1.2.2两个版本节点。此举方便用户在升级后,能够直接对比新旧工作流的表现,早期版本的 ID 在 v1.3 中不再注册,但历史文件仍保留可用。 - MOSS 风格布局预设:新增 7 视图布局选项。具体空间排列为:左侧堆叠两个肖像,中央放置三个身体视图,最右侧上方为手部,下方为脚部。
- 指南逻辑统一与尺寸优化:ON 和 OFF 状态现使用相同的指南排列与尺寸显示。在 OFF 状态下,指南图像输出为 None,但 UI 仍保持一致。同时,缩小了指南边距与间隙,加宽了自动全身列,确保人物在请求的面板高度内保持原始比例。需注意,自动输出宽度的增加可能会延长生成时间并提高 VRAM 占用。
- UI 紧凑化与服装逻辑规范:精简了控件与设置选项卡,移除了独立的“磨损/服装”UI 开关。服装形状现保留为自动、裤子、裙子或长袍选项,v1.3 会将保存的磨损值规范化为服装提取指令。
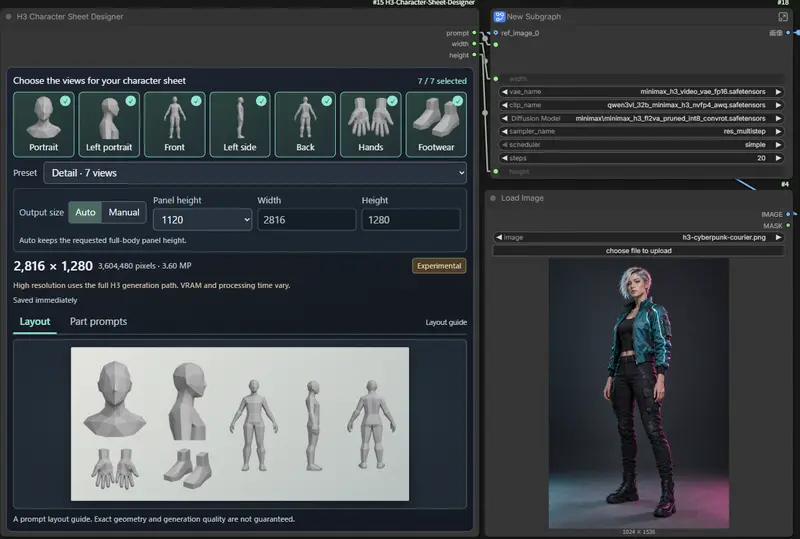
- 新子图工作流模板:提供包含四个角色/部件图像输入和八个 Designer 输出的 v1.3 子图工作流。该模板默认配置为使用 Hybrid V4 模型、H3 INT8 文本编码器 (TE) 以及 Pika Ref2VA。
安装与模型部署
本节点的安装与模型配置是工作流能否正常运行的前提,请严格按以下步骤执行。
1. 节点安装与更新
打开终端,进入 ComfyUI 的自定义节点目录,执行以下命令:
cd ComfyUI/custom_nodes
git clone https://github.com/ukr8b3g-cmyk/H3-Character-Sheet-Designer.git
若为更新现有安装:请通过常规的 Git pull 或 ComfyUI Manager 工作流更新代码,随后必须重启 ComfyUI 服务并强制刷新浏览器(Ctrl+F5)以清除缓存。
2. 模型下载与目录放置
模型权重需单独下载,请严格按照以下路径存放,以确保模板正常调用(minimax/ 子文件夹为模板组织建议,非 ComfyUI 强制约定,但建议遵循):
| 组件类型 | 推荐文件名 | 存放路径 (MODELS/ 下) |
|---|---|---|
| 扩散模型 | DasiwaMinimaxH3_dasiwaHybridV4_int8.safetensors | diffusion_models/minimax/ |
| 文本编码器 (CLIP) | qwen3vl_32b_minimax_h3_int8_convrot.safetensors (或 NVFP4 AWQ 版本) | text_encoders/ |
| 视频 VAE | minimax_h3_video_vae_int8_convrot.safetensors (或 FP16 版本) | vae/ |
| Pika LoRA | pika_h3_flex_ref2va_v1_bf16.safetensors (启用) 或 fl2va (禁用) | loras/minimax/ |
关键兼容性警告:必须将 CLIP 加载器类型设置为
minimax并选择 H3 编码器。若错误使用 Music3 编码器,将直接导致采样器矩阵形状错误(例如 32768 与 5120 维度不匹配)而使工作流崩溃。
3. 运行依赖
Designer 节点本身不添加额外的 Python 运行时依赖。但提供的模板工作流需要原生 ComfyUI 的 H3/子图支持,以及 rgthree-comfy 插件中的 Power LoRA Loader。
工作流配置与接线指南
- 加载工作流:下载并打开
H3_Character_Sheet_Designer_v1.3.json文件。 - 资源绑定:在每个连接的 Load Image 节点中,手动选择已下载的模型权重和有效的参考图像。断开 Designer 节点上未使用的可选输入端口,避免无效计算。
- 参数设置:选择所需的视图数量和部件指令。建议固定随机种子 (Seed),以便于在调整参数或对比 v1.2.2 版本时获得可控的参照结果。
- 指南控制策略:建议初始状态将布局图像 (
layout_image) 设为 OFF。当构图指导确实需要介入干预时,再切换为 ON。 - 输入映射关系:Designer 的输出会直接映射至原生 H3 输入。
character_image对应ref_image_0,layout_image对应ref_image_1,其余参考图像依次对应ref_image_2/3/4。系统会自动跳过 None 图像,四个图像直通输出将原样保留输入张量。 - 提示词解析优先级:在编写部件提示时,系统的解析优先级为:显式文本选择和部件指令 > 专用参考图像 > 基线角色图像。需明确,这些是基于文本的权限分配,并非区域注意力隔离,单独的面板描述无法绝对保证指令仅作用于单一面板内。模板默认采样五帧,并保存第一个解码帧作为静态表。
技术边界与使用限制
为保证客观评估,需明确 v1.3 版本的工程边界,管理使用预期:
- 视觉质量未发生质变:服装和全 13 视图的更新属于针对性微调,并非视觉质量的重大升级。人物特征残留、视角缺失/重复、服装与身体混淆等现象,在照片、动漫或 CG 风格中仍可能发生。
- 参考机制的固有局限:原生图像参考无法保证绝对的身份一致性、未见角度的准确性、服装的高保真度或严格的几何形状。指南图像有时会影响解剖结构或被意外复制。
- 性能与画质的区分:更紧凑的边距和更大的指南人物属于几何布局变化,不代表 GPU 渲染质量的提升。自动宽度的增加会直接转化为更高的时间和显存成本,如有需要可手动限制画布宽度。
- 架构未变:本次更新未引入额外的 LLM 文本生成步骤、硬 BREAK 分离或独立编码的区域条件。打包的编译器/UI 测试与实际的 GPU 生成质量是分开验证的,当前版本未提供受控的多参考/种子成功率、VRAM 或速度基准数据。
© 版权声明
文章版权归作者所有,未经允许请勿转载。