亚马逊AWS推出开发工具TorchNeuron,帮助AI开发者快速把基于PyTorch构建的AI应用迁移到亚马逊自研Trainium芯片,这也是亚马逊针对英伟达AI算力生态发起的一次重量级挑战。长久以来,CUDA软件栈构建起的生态壁垒,让英伟达GPU成为AI项目的默认硬件选择。AWS希望借助TorchNeuron降低迁移门槛,推动自家Trainium芯片成为AI训练与推理的主流算力选项。
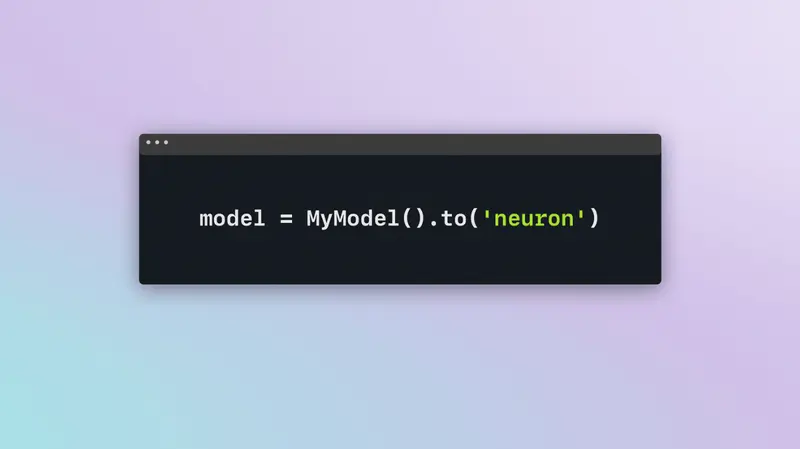
PyTorch是目前AI领域主流开源框架,行业约85%的AI应用都基于它开发。英伟达多年持续打磨CUDA与PyTorch的适配,深度绑定这套框架,形成很强的用户锁定。TorchNeuron深度适配PyTorch,开发者仅修改一行配置,无需重写业务代码,就能把现有PyTorch模型跑在Trainium芯片上。AWS并非首个做PyTorch跨硬件适配的厂商,AMD、苹果芯片也支持通过简单配置完成移植,但AWS方案的核心卖点在于完整的云原生配套能力。
TorchNeuron与Trainium核心优势
Trainium芯片可以同时承载模型训练与推理任务,并且深度整合AWS全套云基础设施。AWS强调,选择这套方案,开发者不用依赖CoreWeave这类绑定英伟达硬件的专用算力服务商,从原型验证到生产上线的整套基础设施都可以在AWS内部打通,方便初创团队快速迭代与弹性扩容。
AWS引用Deepgram案例佐证性价比,这家语音AI厂商迁移至Trainium之后,同等成本下可以多处理70%的音频数据,同时保持生产级别的识别精度。官方也坦诚,Trainium不一定是每token单价最低的方案,但训练推理共用一套硬件平台,可以优化完整工作流的综合成本。
开源上游规划
亚马逊的布局不止局限于自家工具与芯片。AWS团队计划向PyTorch上游主线仓库提交代码,推动框架剥离原生偏向英伟达的底层逻辑,让PyTorch走向硬件无关化,惠及所有开发者,而不只是Trainium用户。AWS Annapurna Labs技术软件副总裁Colin Brace表示,这件事的核心意义,是打破限制开发者自由选择硬件的生态锁定。
当然这套方案的最终效果仍有待验证。PyTorch本身的设计目标就是屏蔽底层硬件的复杂细节,这次大规模底层改动,有可能实现开发者预期的更多硬件选择与更低成本,也有可能带来额外的配置调试负担。一旦亚马逊成功完成PyTorch和英伟达生态的深度解耦,带来的影响会远远超出芯片市场竞争本身,直接动摇英伟达赖以立足的软件生态根基。
© 版权声明
文章版权归作者所有,未经允许请勿转载。