UniForge3D 是北大、幻元智能、香港科技大学联合提出的三维资产生成框架,专门解决多照片3D重建与AI生成融合的两大痛点:重建分支与生成分支坐标系不统一、全部视图无差别输入造成有效信息被干扰。
- 项目主页:https://xishuxishu.github.io/uniforge3d-project/
- GitHub:https://github.com/xibushu/UniForge3D
- 模型:https://huggingface.co/xibushu/UniForge3D
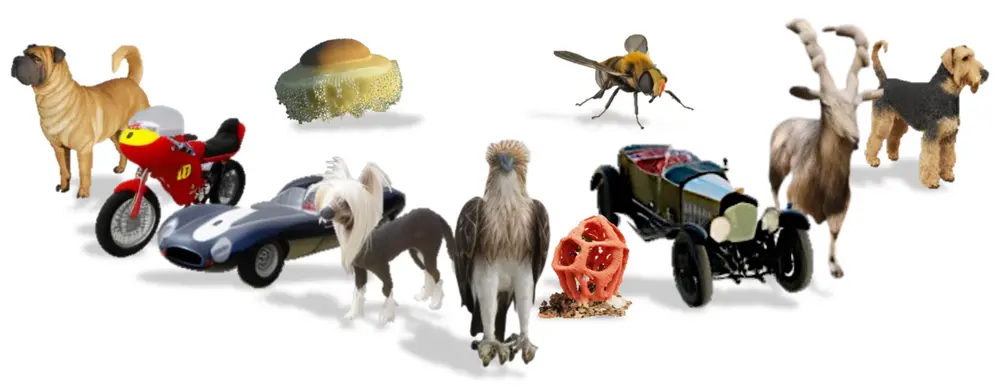
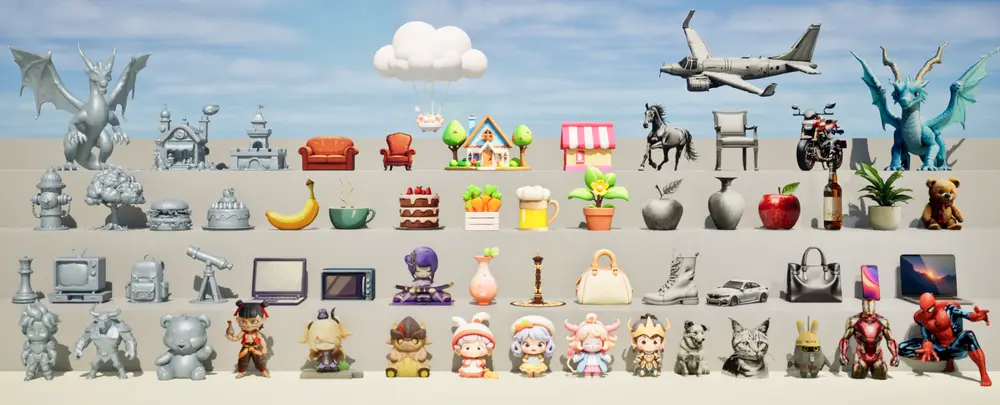
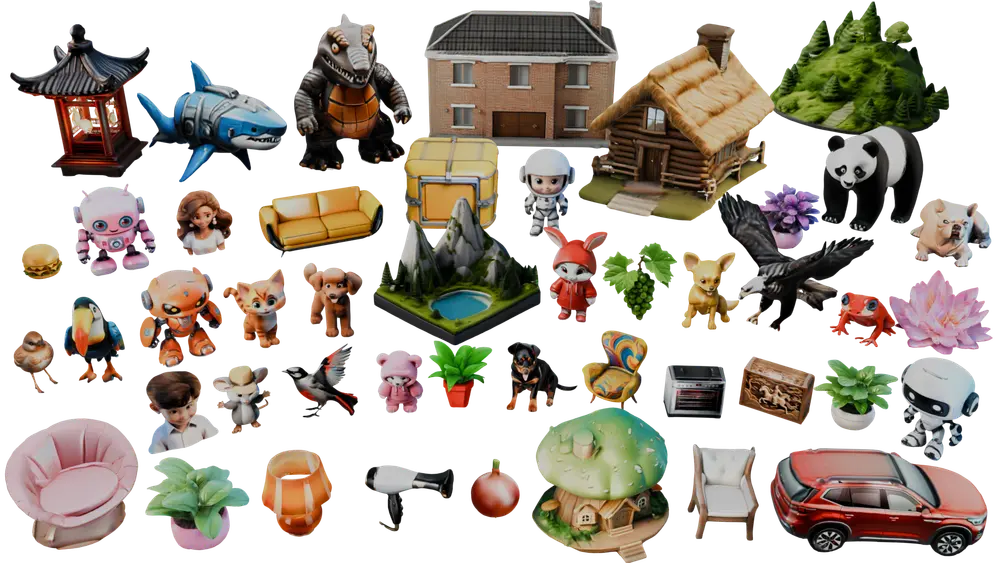
它构建一套锚定引导共享空间,让重建、生成模块在同一坐标系双向协同;并且做到体素级别自动挑选最优参考视图。仅输入少量、无需相机姿态标定的普通照片,就能输出完整带纹理三维网格模型,既严格保留照片可见区域的真实细节,又合理补全被遮挡、不可见的物体背面,产出资产可直接用于游戏引擎、AR展示、3D打印等场景。模型仅支持独立物体,不处理大型场景。
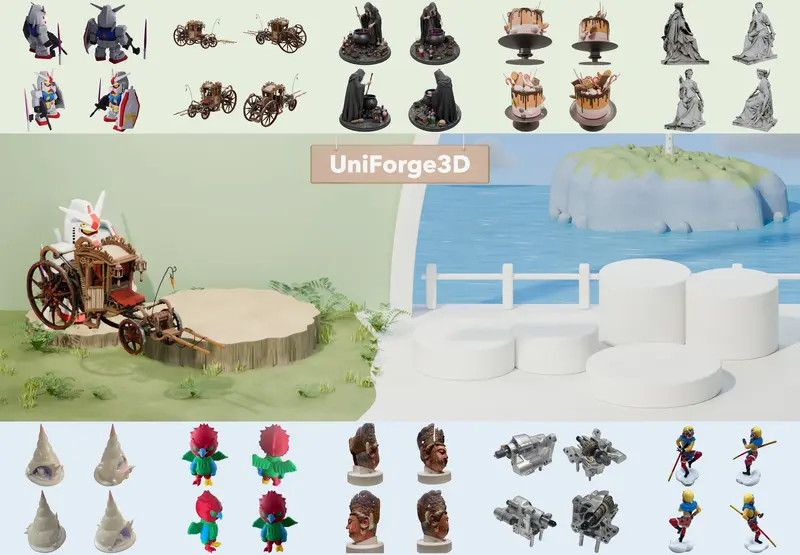
核心技术亮点
- 锚定引导共享空间
选取一张输入图作为锚定视图确定物体朝向,锁定物体竖直方向,重建与生成共用同一套空间定义,不再需要额外坐标变换对齐,分支之间可以直接双向传递信息,规避坐标转换带来的误差与信息丢失。消融实验证实,这套共享空间是整套框架效果的核心基础。 - 重建与生成双向协同
并非“先重建、后生成”的串行流水线。重建把实拍几何信息传给生成,约束生成模块不能随意篡改照片可见结构;生成分支输出完整物体全局结构反向辅助重建,提升三维点位置预测精度,两个分支互相增益。 - 体素级视图智能挑选
针对三维物体每一小块体素,自动评估所有输入照片对该区域的参考价值,优先选用遮挡最少、画面最清晰的视图作为局部细节生成依据;完全无视图覆盖的区域,会参考邻近区域视图信息,避免模糊、遮挡照片污染局部细节。 - 由粗到细两步生成
第一阶段双向交互得到稀疏体素粗略结构;第二阶段基于粗结构做视图筛选,再精细化生成几何外形与表面纹理,形状与纹理一体化输出。
实验评测
在Toys4K、GSO标准三维数据集,固定输入4张无姿态照片,与Mix3R、ReconViaGen、Hunyuan3D‑2MV等主流方案对比:
- 在几何准确度、外观渲染两大核心指标均取得最优;
- 消融实验验证:共享空间、双向联合训练、体素视图挑选三项设计,都能单独带来显著指标提升;
- 现存局限:训练数据以合成渲染素材为主;遇到强反光、大面积遮挡、极端光照的实拍素材,效果会下降;仅支持单个独立物体。
应用场景
- 游戏/数字文创:手办、器物、展品少量实拍照片,快速生成游戏道具、虚拟展厅3D展品,补齐背面模型,减少手工建模工作量。
- 电商AR/虚拟展示:手机多角度拍摄实物,快速生成商品3D模型,用于网页3D预览、AR试看。
- 机器人仿真:批量生成实物三维模型,构建机器人抓取仿真数据集。
- 个人创作:普通用户用手机拍照,制作3D打印模型、短视频虚拟道具,降低三维数字化门槛。
- 科研领域:为多视图三维重建+生成融合方向提供新的基线方案。
© 版权声明
文章版权归作者所有,未经允许请勿转载。