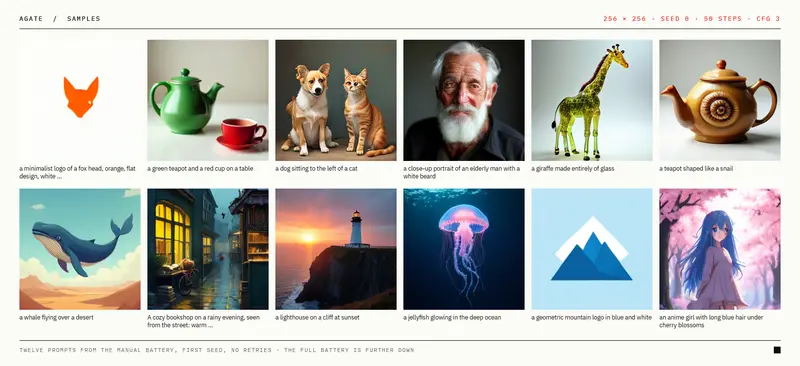
LogoLabs 推出轻量文生图模型 Agate Preview 001,260M参数量,仅消耗145 GH200训练算力,GenEval得分0.550,和SDXL持平,远高于SD1.5、SD2.1、PixArt-α。模型体积小巧,RTX4060可实现2秒内出图,MIT协议开放权重与代码,主打图标、Logo、构图草稿场景。
- 模型:https://huggingface.co/Logolabs/agate-preview-001
- ComfyUI:https://github.com/logolabs/agate-comfyui
基础信息
| 项目 | 参数 |
|---|---|
| 任务 | 文生图,固定256×256分辨率,英文提示词 |
| 模型规模 | 260M(搭配TAESD);完整管线带SD-VAE为308.5M 生成器190.9M + Ettin文本编码器68.1M |
| 训练数据 | FLUX-Reason-6M,约146.9M图像,26个epoch |
| 训练算力 | 144.7 GH200小时,墙钟总时长不到13小时 |
| 能耗 | 模型训练81.8 kWh,碳排放2.45 kg CO₂e;完整项目176.7 kWh |
| GenEval | 0.550,与SDXL持平 |
| Qwen-Image-Bench | 28.2,接近SD1.5的29.1 |
| 推理速度 | RTX4060,50步1.9秒;ComfyUI中50步1.7秒,30步草稿仅1.05秒;支持WebGPU浏览器端运行 |
| 许可证 | MIT(权重+代码) |
| 状态 | 研究预览版,尚未完全收敛 |
强弱项
- ✅ 优势:物体位置摆放、色彩和对象绑定、人脸、扁平Logo风格、长提示词理解
- ⚠️ 短板:文字渲染、3个以上物体计数、否定提示效果一般;固定256px分辨率,不支持大图生成;模型仍在迭代
核心架构:Thinker规划 + Renderer卷积渲染
Agate采用先规划,再绘制的双模块设计,分离空间规划与像素渲染:
- Thinker(小型循环Transformer规划器)
读取提示词,理解2D空间位置关系,经过4轮思考,输出16×16潜空间区域布局规划。擅长解析「物体放在左边/上方」这类空间指令,能从长提示词提取关键信息。 - Renderer(FCDM-T2卷积U-Net渲染器)
纯卷积结构,不带注意力机制,不读取文本。仅依照Thinker输出的布局方案绘制图像,7×7卷积带来边缘、纹理、光影的强图像先验,像素渲染成本很低。
简单来说:Transformer负责思考构图与位置,卷积网络负责画像素,扬长避短。消融实验证明:加入Thinker模块后,GenEval、Qwen图像评测同步提升,位置绑定、色彩绑定能力显著增强。
ComfyUI 集成
官方提供ComfyUI自定义节点logolabs/agate-comfyui
- 节点:Agate Loader、Agate Sampler、一体化Agate Generate
- 权重:
agate-preview-001.safetensors522MB bf16,自动下载 - 兼容SD1.5标准latent,可直接对接原生VAE解码、图像放大、img2img,支持
--lowvram低显存模式 - 附带txt2img、批量生成、4倍放大等现成工作流
定位:小模型的适用场景
Agate不是用来替代大模型出高质量成品图,而是填补轻量化、低成本、可私有化部署的构图草稿需求:
- 本地设备离线预览:提示词、图像不出本机,WebGPU浏览器直接跑
- 实时打字预览:低步数草稿亚秒级刷新,适合Logo设计工具边输入边看效果
- 批量生成图标/变体图、合成训练数据集,单卡每小时可产出约1900张
- 领域定制:从头完整训练仅需一夜,品牌、图标风格可以单独定制专属模型
- 研究实验:消融、奖励模型、采样器迭代,GPU算力成本低
- 管线搭配:Agate快速输出构图草稿,再交由大模型或Inkvec矢量化器完成高清成品与矢量Logo
注意:当前只是预览检查点,模型还未收敛,各项指标仍在上升。官方计划继续加倍训练,投入额外145 GPU小时,预期会带来明显性能提升。
© 版权声明
文章版权归作者所有,未经允许请勿转载。