Gradium AI 于 2026 年 8 月 31 日正式将其最新的文本转语音(TTS)模型设为 API 和 Studio 的默认引擎。这款新模型专为解决语音代理在通话中最易出错的痛点而生——即订单号、回拨数字、电子邮件地址等复杂信息的准确播报。数据显示,其在“硬案例”上的准确率显著领先于 Cartesia、ElevenLabs 等主流竞品,同时保持了极低的延迟和极高的稳定性。
- 官方介绍:https://gradium.ai/blog/gradium-tts-latency-and-accuracy
- 数据:https://huggingface.co/datasets/gradium/tts-eval-customer-support-202608
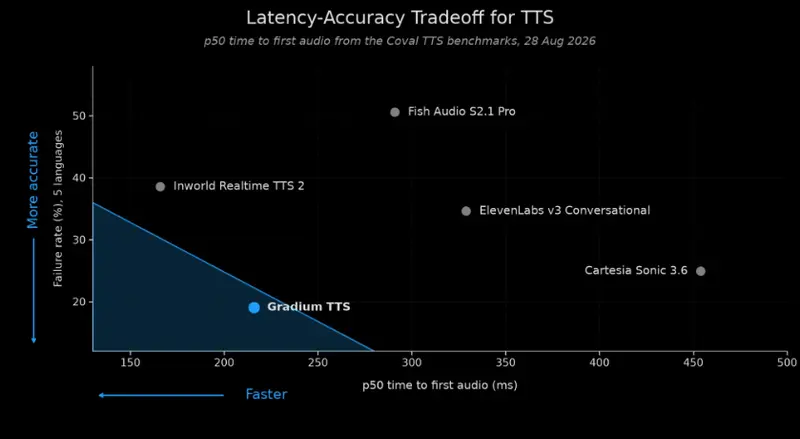
核心亮点:准确率与速度的双重突破
- 81.0% 硬案例通过率:
- 在涵盖英、德、法、西、葡五种语言的 500 句高难度测试集(包含字母数字混合、日期、大数、邮箱、IBAN 等)中,Gradium 新模型取得了 81.0% 的人工评分通过率。
- 对比优势:大幅领先于 Cartesia Sonic 3.6 (75.1%)、ElevenLabs v3 Conversational (65.4%)、Fish Audio S2.1 Pro (49.5%) 及 Inworld TTS 1.5 Max (46.5%)。
- 216ms 首帧音频时间 (TTFA):
- 在 Coval 基准测试中,P50 延迟仅为 216 毫秒,比其前代模型快了 170 毫秒。
- 极致稳定:在 480 次运行中,四分位距(IQR)仅为 30 毫秒,是测试模型中分布最紧凑的。这意味着用户极少遇到因尾部延迟导致的通话卡顿,体验远优于中位数更低但波动大的模型(如 Inworld TTS 2)。
- 无缝升级,无需迁移:
- 现有声音 ID(包括自定义克隆)继续正常工作,开发者无需修改代码即可享受性能提升。
为什么“硬案例”如此重要?
在语音代理场景下,自然度不再是唯一指标,信息传递的准确性才是关键。Gradium 构建并开源了(CC BY 4.0)一个严格的评估集,重点测试以下容易出错的元素:
- 原子标准:拼写、首字母缩略词、字母数字混合令牌、日期、常规数字、大数、浮点数、电子邮件。
- 复合标准:模拟真实对话中的订单确认、IT 工单记录、索赔信息等复杂语境。
评分规则极其严格:只要母语评分者听到任何一个元素发音错误或遗漏,整句话即判定为失败。这种严苛的标准确保了模型在真实业务场景中的可靠性。
技术优势解析
| 维度 | Gradium 新模型 | 竞品表现 (参考) | 优势解读 |
|---|---|---|---|
| 硬案例通过率 | 81.0% | Cartesia: 75.1% ElevenLabs: 65.4% | 在处理复杂数据时更可靠,减少用户重复确认的次数。 |
| 首帧延迟 (P50) | 216 ms | Inworld: 166 ms Cartesia: 454 ms | 虽非绝对最快,但在低于 250ms 的区间内实现了最佳平衡。 |
| 延迟稳定性 (IQR) | 30 ms | Cartesia: 165 ms | 波动极小,确保通话流畅,避免因网络或计算抖动造成的体验断层。 |
| 文本预处理 | 无需归一化 | 多数模型需预处理 | 直接读取原始文本中的电话号码、邮箱等,简化开发流程。 |
快速开始
- 现有用户:无需任何操作,API 和 Studio 已自动切换至新默认模型。
- 新用户:安装 Python SDK,指向 WebSocket TTS 端点,重用现有声音 ID 即可。
- 社区激励:Gradium 在其 Discord 上提供 100 万积分奖励,鼓励开发者提交完整的硬案例失败报告,以进一步优化模型。
© 版权声明
文章版权归作者所有,未经允许请勿转载。